

10 лучших альтернатив Janitor AI в 2026 году
21.06.2026 12 мин
В Requests укажите timeout=5 или раздельные лимиты timeout=(3, 10): для подключения и ожидания данных. По умолчанию Requests не задаёт таймаут. Параметр timeout не ограничивает полную длительность загрузки.
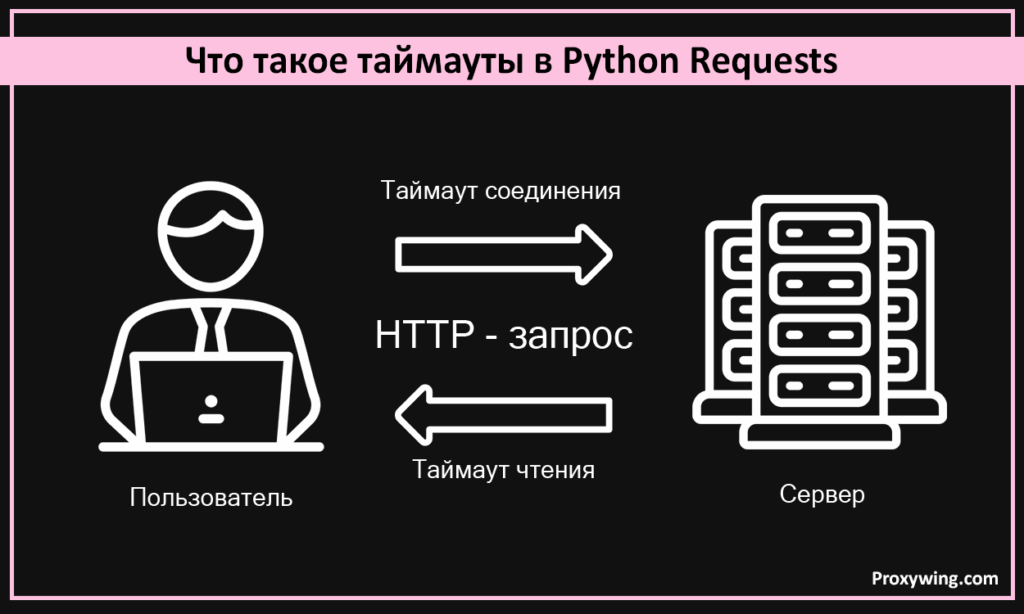
Ниже показаны рабочая обработка исключений, обёртка Session со значением по умолчанию и конечная политика повторов. Отдельно разобрано, почему запрос способен выполняться дольше суммы двух таймаутов.
timeout задаётся в секундах. Одно число применяется к подключению и чтению; кортеж содержит два отдельных значения.
| Запись | Подключение | Чтение |
|---|---|---|
timeout=5 |
До 5 секунд на попытку соединения | До 5 секунд ожидания данных |
timeout=(3, 10) |
До 3 секунд на попытку соединения | До 10 секунд ожидания данных |
timeout=None |
Явный лимит отключён | Явный лимит отключён |
Connect timeout ограничивает установку соединения. Read timeout ограничивает ожидание первых данных и паузы между поступающими данными. Если сервер регулярно присылает небольшие части ответа, загрузка может продолжаться дольше 10 секунд.
timeout=(3, 10) не означает общий предел 13 секунд. Несколько IP у домена, повторы и редиректы способны увеличить длительность. DNS-разрешение также не подчиняется простой гарантии общего предела параметром timeout.
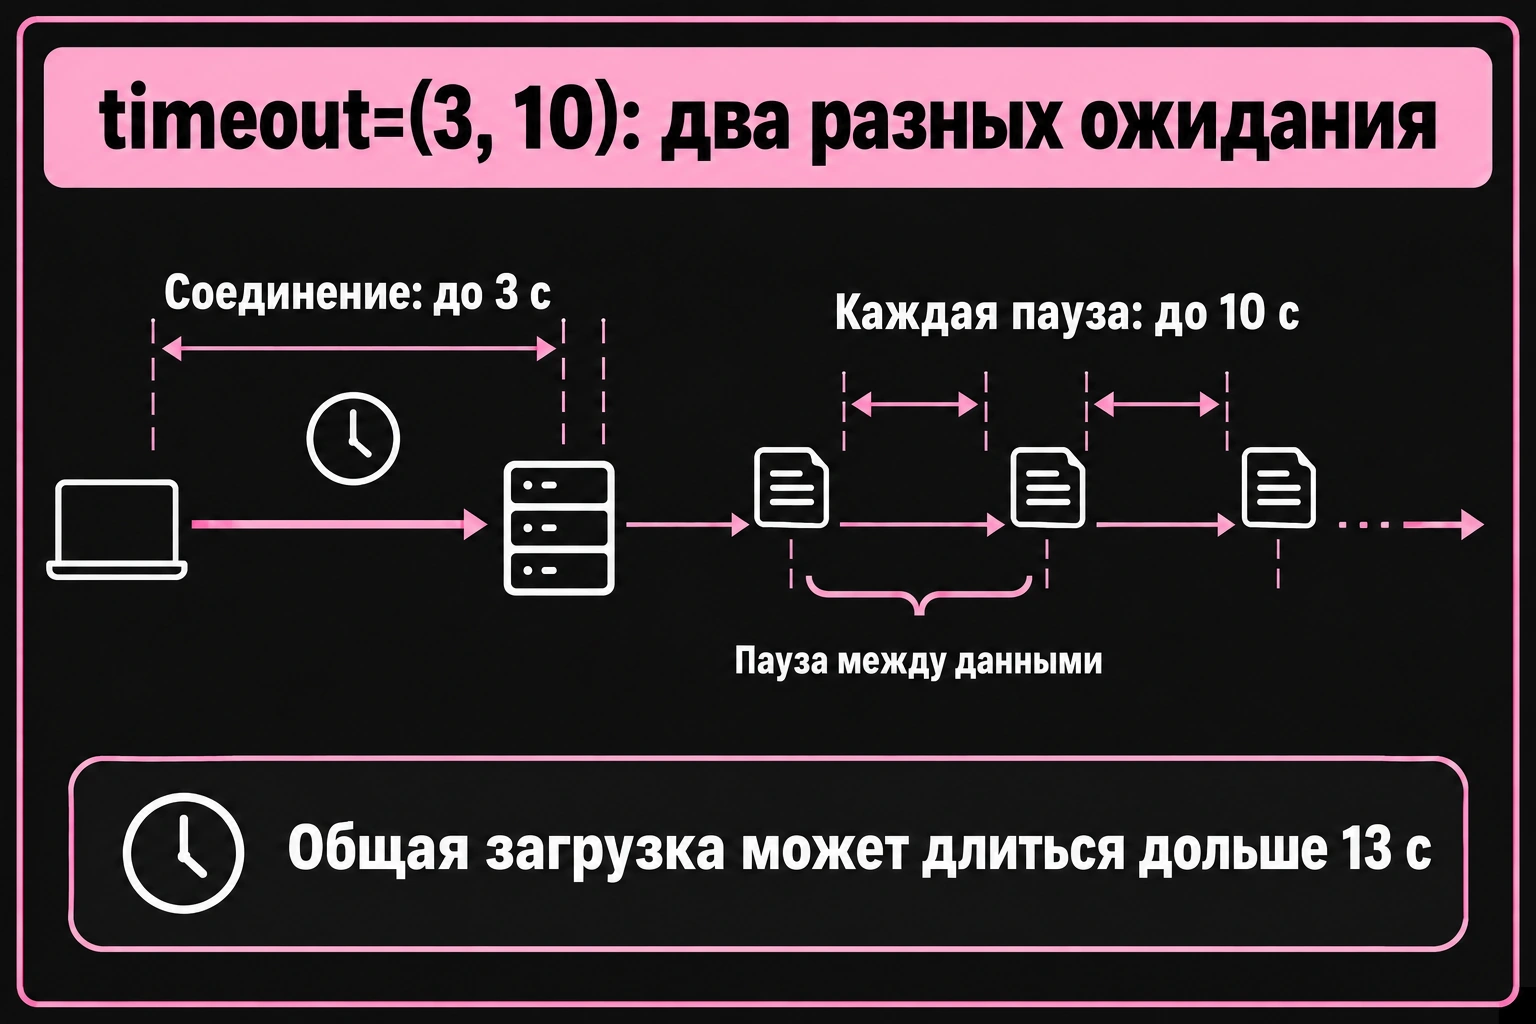
Без таймаута занятый сетевым ожиданием поток может долго не возвращать управление. Это задерживает обработку остальных URL и расходует ресурсы приложения.
Таймаут помогает завершить конкретное ожидание контролируемой ошибкой. Он не предотвращает блокировку IP и не гарантирует доступность сервера. Сначала выберите лимит под задачу, затем решите, допустим ли повтор операции.
import requests

response = requests.get("https://httpbin.org/get", timeout=5)
response.raise_for_status()
print(response.status_code)
В этом примере оба таймаута равны пяти секундам. Для раздельной настройки замените вызов:
response = requests.get("https://httpbin.org/get", timeout=(3, 10))
Дробные положительные числа допустимы, например timeout=(3.05, 27). Значения в учебных примерах не служат универсальной рекомендацией. Подбирайте их по замерам вашей цели и допустимому ожиданию пользователя.
Один и тот же параметр применяется к get, post и другим методам. Сам метод не определяет подходящий таймаут: учитывайте объём ответа и обработку на сервере.
import requests

try:
    response = requests.get("https://httpbin.org/get", timeout=(3, 10))
    response.raise_for_status()
except requests.exceptions.ConnectTimeout:
    print("Не удалось установить соединение за отведённое время")
except requests.exceptions.ReadTimeout:
    print("После подключения данные не поступили вовремя")
except requests.exceptions.Timeout:
    print("Превышен лимит ожидания")
except requests.exceptions.HTTPError as exc:
    print("HTTP-ошибка:", exc.response.status_code)
except requests.exceptions.RequestException as exc:
    print("Сетевая ошибка:", type(exc).__name__)
else:
    print(response.status_code)
Перехватывайте частные исключения раньше базового RequestException. HTTP 408 или 504 приходит как HTTP-ответ; это отличается от локального исключения Timeout. Проверка raise_for_status() превращает статус 4xx/5xx в HTTPError.
Таймаут чтения не доказывает, что сервер не выполнил действие. При повторе POST можно создать дубликат. Проверьте результат операции или передайте ключ идемпотентности, если API его поддерживает.
При потоковом чтении iter_content() таймаут может оказаться обёрнут в ConnectionError. Поэтому внешний обработчик RequestException полезен и для загрузок с stream=True.
У requests.Session нет штатной настройки session.timeout. Присваивание такого атрибута не меняет сетевые вызовы. Задайте обёртку над request:
import requests

class TimeoutSession(requests.Session):
    def __init__(self, default_timeout=(3, 10)):
        super().__init__()
        self.default_timeout = default_timeout

    def request(self, method, url, **kwargs):
        kwargs.setdefault("timeout", self.default_timeout)
        return super().request(method, url, **kwargs)

with TimeoutSession() as session:
    response = session.get("https://httpbin.org/get")
    response.raise_for_status()
    print(response.status_code)
    # Для этого вызова применяется отдельное значение.
    response = session.get("https://httpbin.org/get", timeout=(5, 20))
    response.raise_for_status()
Контекст with закрывает сессию после выполнения. Явно переданное timeout=None отключит лимит для этого вызова, поскольку setdefault сохраняет указанный аргумент.
Requests выполняет блокирующие операции. В каждом рабочем потоке передавайте timeout так же, как при обычном вызове. Создавайте отдельную Session на поток: cookies могут обновляться автоматически при получении ответа.
future.result(timeout=10) прекращает ожидание результата вызывающим кодом. Уже запущенный запрос в потоке продолжает выполняться. Такой вызов не заменяет сетевой timeout и не даёт принудительной отмены операции.
В asyncio прямой вызов Requests блокирует цикл событий. Для асинхронного приложения используйте подходящий клиент. Например, aiohttp.ClientTimeout(total=30, sock_connect=5, sock_read=10) разделяет общий лимит, установку нового соединения и чтение. HTTPX разделяет connect, read, write и pool timeout.
Выбор клиента подробно разобран в сравнении HTTPX, Requests и aiohttp.
| Когда возникает сбой | Что проверить |
|---|---|
| Соединение не установлено | Имя хоста, DNS, порт, доступность сети и правила файрвола |
| Подключение прошло, данных нет | Задержку API, нагрузку бэкенда и ожидание первого байта |
| Ошибка появляется только с прокси | Протокол, порт, авторизацию и маршрут до того же целевого URL |
| Ответ идёт небольшими частями | Паузы между частями и общий бюджет операции |
| Серия запросов длится слишком долго | Число повторов, задержки backoff и редиректы |
Сначала выполните один запрос, затем сравните прямой маршрут и маршрут через прокси. Инструкция по подключению прокси к Requests поможет исключить влияние окружения. Смена IP не устраняет медленный бэкенд.
Если нужен отдельный маршрут для проекта, выберите индивидуальные прокси ProxyWing и проверьте задержку на своей цели.
Начните с явной пары лимитов. Измеряйте полную длительность через time.perf_counter(), фиксируйте тип исключения и домен цели. response.elapsed отражает время до получения заголовков; полную загрузку тела оно не измеряет.
Разделяйте измерения для разных API и маршрутов. Увеличивайте конкретный лимит, который регулярно срабатывает на допустимых ответах. Одновременное увеличение всех значений скрывает место задержки.
Задайте конечный бюджет попыток. Учитывайте, что время ожидания между повторами тоже входит во время работы приложения.
Следующий пример делает GET и допускает два повтора подключения или подходящего HTTP-статуса. Повторы чтения отключены.
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

retry = Retry(
    total=2, connect=2, read=0, status=2, other=0,
    allowed_methods={"GET", "HEAD"},
    status_forcelist=[429, 502, 503, 504],
    backoff_factor=0.5,
    respect_retry_after_header=True,
    raise_on_status=False,
)
with requests.Session() as session:
    session.mount("https://", HTTPAdapter(max_retries=retry))
    response = session.get("https://httpbin.org/get", timeout=(3, 10))
    response.raise_for_status()
    print(response.status_code)
Первоначальная попытка не входит в total=2, поэтому попыток будет не более трёх. timeout=(3, 10) при трёх попытках не даёт общего предела в 30 секунд. Read timeout ограничивает ожидание данных; паузы backoff и Retry-After добавляются к общему времени.
POST здесь не включён в разрешённые методы. Для операций записи согласуйте повторы с контрактом API. Не добавляйте поверх адаптера ещё один бесконечный цикл.
Если нужен клиент с таймаутами по умолчанию и синхронным или асинхронным API, рассмотрите HTTPX. Для приложения на asyncio с общим лимитом запроса подходит aiohttp. У Requests остаётся понятная синхронная модель; её таймауты задаются явно.
Общий deadline приложения планируйте отдельно. Для жёсткой остановки блокирующей операции требуется управление жизненным циклом задачи или процесса. Ожидание результата потока с таймаутом эту задачу не решает.
Проверьте обычный ответ, отказ в соединении (ConnectionError), адрес без ответа и задержку чтения на контролируемом сервере. Отказ соединения не равен истечению connect timeout. Для каждого случая зафиксируйте исключение и время работы. По журналу тестового сервера убедитесь, что при ответе 503 пришло не более трёх запросов.
Статью написал:
Фулстек AI-инженер
Александр привносит в инженерную команду Proxywing глубокую фулстек-экспертизу — от архитектуры бэкенда и оптимизации производительности до AI-ориентированных процессов разработки. Его практический опыт охватывает Node.js, React, облачную инфраструктуру и RAG-пайплайны, что позволяет одинаково уверенно работать как с внутренней логикой прокси-платформы, так и с пользовательской частью продукта. В Proxywing Александр сосредоточен на проектировании отказоустойчивых систем, устранении узких мест производительности и внедрении современных AI-инструментов в процесс разработки. Вне кода он увлечён исследованием передовых подходов в AI-инженерии и созданием сайд-проектов, расширяющих технические горизонты.
Все статьи автора (58)
