

WEB-прокси для Telegram: что это, где взять и как подключить
19.10.2026 6 мин
Библиотека HTTPX отправляет HTTP-запросы из Python через синхронный Client или асинхронный AsyncClient. Requests использует синхронный API, aiohttp работает на asyncio и также предоставляет серверные возможности. Выбирайте по архитектуре приложения, нужным протоколам и управлению соединениями.
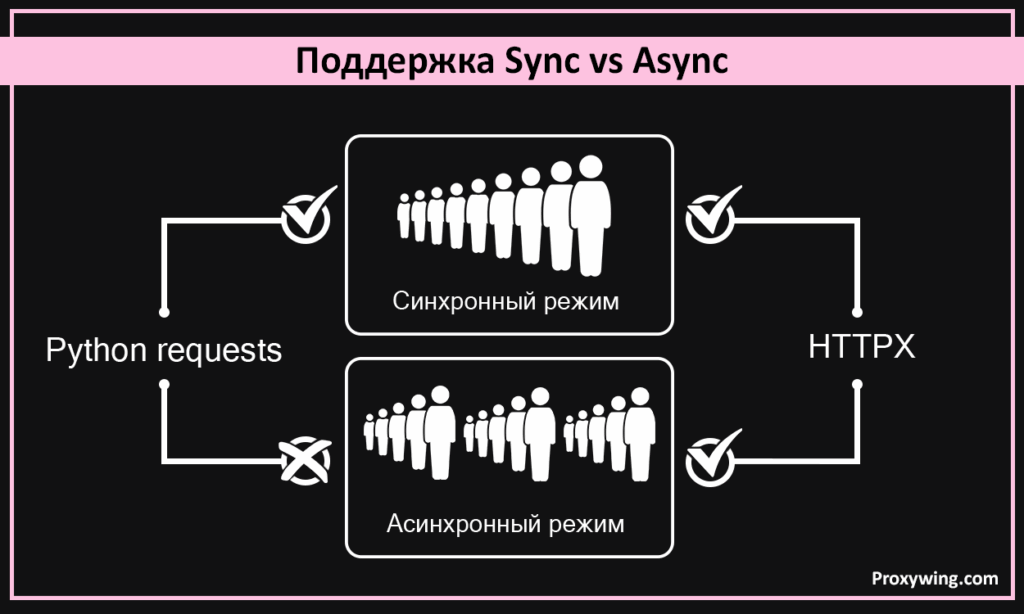
В статье сравниваются именно Python-библиотеки. Одноимённая утилита httpx от ProjectDiscovery написана на Go и решает другую задачу. Скорость клиентов зависит от сервера, сети, размера ответа и числа одновременных запросов; универсального победителя по времени выполнения нет.
| Задача | С чего начать | Что учесть |
|---|---|---|
| Синхронный скрипт или существующая интеграция | Requests | Явно задайте timeout и используйте Session |
| Нужен общий подход для sync и async | HTTPX | Закрывайте Client через with, AsyncClient через async with |
| Нужен HTTP/2 | HTTPX с HTTP/2 extra | Включите http2=True, проверьте версию ответа |
| Приложение на asyncio с WebSocket | aiohttp | Используйте ClientSession и настройте TCPConnector |
| Много сетевых ожиданий | HTTPX AsyncClient или aiohttp | Ограничьте одновременные обращения и учтите лимиты цели |
Асинхронность даёт другим задачам выполняться во время сетевого ожидания. Она сама по себе не ускоряет удалённый сервер и не снимает ограничения частоты.
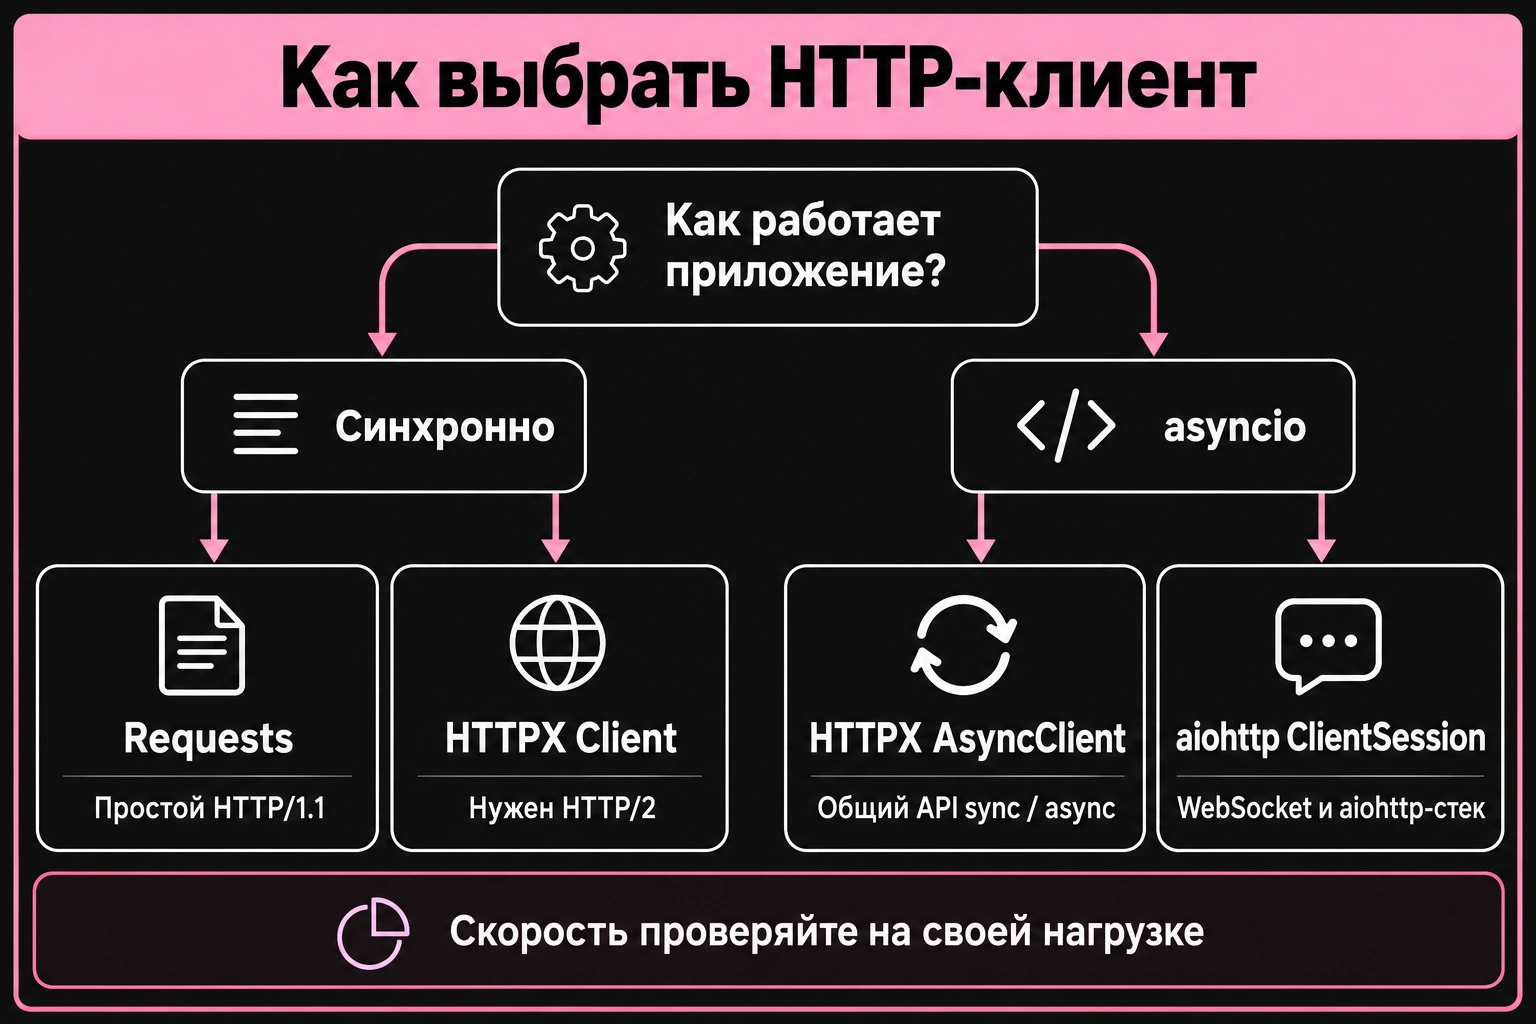
HTTPX предоставляет синхронный и асинхронный HTTP-клиент для Python с опциональным HTTP/2. Сопоставьте режим работы, пул соединений и ошибки с требованиями проекта. Затем проверьте совместимость кода: похожие имена методов не означают одинаковое поведение. Базовые HTTP-вызовы, JSON и cookies поддерживают оба клиента.
Один обычный вызов Requests блокирует вызывающий поток до получения результата. Несколько запросов можно запускать через пул потоков; это отдельная модель конкурентности. Прямой вызов Requests внутри async def блокирует цикл событий.
HTTPX предлагает синхронный Client и асинхронный AsyncClient. Для конкурентного выполнения нужны await и запуск нескольких задач. Последовательный цикл с await client.get() остаётся последовательным.
Requests со стандартным транспортом использует HTTP/1.1. HTTPX поддерживает HTTP/2 опционально:
python -m pip install "httpx[http2]"
Пример клиента:
import httpx

with httpx.Client(http2=True, timeout=10) as client:
    response = client.get("https://www.example.com")
    response.raise_for_status()
    print(response.http_version)
Обе стороны должны поддерживать HTTP/2. Если сервер предлагает только HTTP/1.1, клиент использует его. Проверяйте response.http_version. HTTP/2 поддерживает несколько потоков в одном соединении, но выигрыш зависит от нагрузки и сервера.
requests.Session, httpx.Client и httpx.AsyncClient сохраняют пул соединений. Создавайте клиент на серию запросов и закрывайте его после работы. Новый клиент внутри каждого прохода цикла теряет пользу повторных соединений.
Requests использует stream=True и iter_content(). HTTPX использует контекст client.stream() с iter_bytes() либо aiter_bytes(). Закрывайте потоковый ответ и при досрочном прекращении чтения.
Пример загрузки через Requests:
import requests

with requests.Session() as session:
    with session.get("https://httpbin.org/bytes/1024", stream=True,
                     timeout=(3, 10)) as response:
        response.raise_for_status()
        with open("result.bin", "wb") as file:
            for chunk in response.iter_content(chunk_size=8192):
                if chunk:
                    file.write(chunk)
Requests не задаёт timeout автоматически. HTTPX по умолчанию ограничивает сетевую неактивность пятью секундами и разделяет connect, read, write и pool timeout. Редиректы GET Requests обычно обрабатывает автоматически; HTTPX требует follow_redirects=True, если переходы нужны.
У Requests raise_for_status() реагирует на 4xx/5xx. У HTTPX метод также поднимает HTTPStatusError для 3xx. При миграции проверяйте это вместе с политикой переходов.
Повторы Requests настраиваются через HTTPAdapter и urllib3.Retry. У HTTPX HTTPTransport(retries=...) повторяет ошибки подключения ConnectError и ConnectTimeout; повторы чтения и HTTP-статусов требуют отдельной логики. Ограничивайте количество попыток и не повторяйте операции записи без проверки идемпотентности.
Подробная настройка Requests вынесена в гайд по timeout и повторам.
Requests принимает словарь proxies=, HTTPX использует proxy= для одного шлюза или mounts с транспортами. Для HTTPX настройте прокси при создании Client или AsyncClient. Значение указывает протокол подключения к прокси и его адрес; HTTPS-сайт часто использует HTTP-прокси через CONNECT. В aiohttp параметр proxy= передаётся запросу. Проверьте авторизацию и влияние окружения в каждом клиенте.
aiohttp это асинхронная библиотека для Python на основе asyncio. Она содержит HTTP-клиент, серверный фреймворк и поддержку WebSocket. Для исходящих запросов используется ClientSession.
Сессия содержит пул соединений. Настройка TCPConnector(limit=..., limit_per_host=...) ограничивает открытые подключения, ClientTimeout разделяет общий и этапные лимиты. Стандартный клиент aiohttp работает с HTTP/1.1 и не поддерживает HTTP/2.
aiohttp имеет смысл выбирать, когда приложение уже использует его экосистему или нуждается в WebSocket. Само название библиотеки не доказывает преимущество в пропускной способности конкретного проекта.
Установите нужные библиотеки. asyncio входит в стандартную библиотеку Python, отдельный пакет устанавливать не требуется:
python -m pip install requests httpx aiohttp
import requests

with requests.Session() as session:
    response = session.get("https://httpbin.org/get", timeout=(3, 10))
    response.raise_for_status()
    print(response.json()["url"])
import asyncio
import httpx

async def main():
    timeout = httpx.Timeout(10, connect=3)
    async with httpx.AsyncClient(timeout=timeout, follow_redirects=True) as client:
        response = await client.get("https://httpbin.org/get")
        response.raise_for_status()
        print(response.json()["url"])

asyncio.run(main())
import asyncio
import aiohttp

async def main():
    timeout = aiohttp.ClientTimeout(total=20, sock_connect=3, sock_read=10)
    async with aiohttp.ClientSession(timeout=timeout) as session:
        async with session.get("https://httpbin.org/get") as response:
            response.raise_for_status()
            data = await response.json()
            print(data["url"])

asyncio.run(main())
Каждый пример выполняет один запрос и закрывает клиент. В среде с уже работающим циклом событий, например в notebook, вызывайте await main() вместо asyncio.run(main()). Для синхронного HTTPX используйте with httpx.Client(...) и уберите await у запроса.
Время без методики и исходного кода не даёт проверяемого сравнения. Замеряйте клиенты на одном разрешённом тестовом сервере с одинаковыми ответами. Сохраните версии Python и пакетов, параметры сети, число запросов и размер тела.
HTTPAdapter(pool_maxsize=..., pool_block=True), httpx.Limits(max_connections=...) и TCPConnector(limit=...). Также ограничьте число работников Requests: pool_maxsize без блокировки не служит строгим пределом.Проверяйте HTTP/1.1 и HTTP/2 отдельными сериями. Не объясняйте разницу протоколом, если фактическая версия ответа не записана. Публичный учебный endpoint подходит для проверки синтаксиса, но не для стресс-теста.
Для конечного списка URL можно ограничить число активных запросов семафором. Пул соединений и семафор решают разные задачи: первый управляет соединениями, второй ограничивает вход в сетевую часть функции.
import asyncio
import httpx

async def fetch(client, semaphore, url):
    async with semaphore:
        response = await client.get(url)
        response.raise_for_status()
        return response.status_code

async def main():
    urls = ["https://httpbin.org/get"] * 3
    semaphore = asyncio.Semaphore(2)
    limits = httpx.Limits(max_connections=2, max_keepalive_connections=2)
    timeout = httpx.Timeout(10, connect=3)
    async with httpx.AsyncClient(limits=limits, timeout=timeout) as client:
        result = await asyncio.gather(
            *(fetch(client, semaphore, url) for url in urls)
        )
        print(result)

asyncio.run(main())
Пример запускает всего три учебных запроса. Для большого потока URL используйте ограниченную очередь и постоянных работников: создание миллионов задач сразу расходует память даже при семафоре. Число соединений не заменяет ограничение запросов в секунду.
Сначала сравните долю успешных ответов. Клиент, который завершил серию быстрее за счёт таймаутов или ответов 429, не обязательно выполнил полезную работу быстрее.
Затем сопоставьте задержки и ресурсы при одинаковой нагрузке. Большие ответы могут упереться в канал и память, маленькие запросы к одному хосту зависят от пула и протокола. Число URL само по себе не описывает тест.
Отдельно измерьте прямой маршрут и маршрут через один и тот же прокси. Задержка шлюза и политика ротации могут повлиять на итог сильнее, чем выбор HTTP-библиотеки.
| Возможность | Requests | HTTPX | aiohttp |
|---|---|---|---|
| Режим API | Sync | Sync и async | Async на asyncio |
| Повторные соединения | Session | Client / AsyncClient | ClientSession |
| HTTP/2 | Нет в стандартном транспорте | Опционально | Нет в стандартном клиенте |
| Таймауты | Connect и read, явно | Connect, read, write, pool | Total, connect, sock_connect, sock_read |
| Потоковый ответ | iter_content() |
iter_bytes() / aiter_bytes() |
response.content |
| JSON | response.json() |
response.json() |
await response.json() |
| HTTP-прокси | proxies= |
proxy= или transports в mounts |
proxy= |
| Прокси окружения | По умолчанию учитываются | По умолчанию учитываются | trust_env=True для включения |
| WebSocket | Нет встроенного клиента | Нужны дополнительные средства | Есть клиент и сервер |
| Серверный фреймворк | Нет | Нет | Есть |
При переносе настройки Requests не передавайте словарь proxies в актуальный HTTPX. Для одного шлюза используйте proxy= при создании клиента. Схему адреса сверяйте с протоколом прокси. Формат прокси-URL и авторизация в Requests разобраны отдельно.
Если проекту нужен отдельный выходной IP, выберите индивидуальные прокси ProxyWing и проверяйте каждый клиент с одинаковыми параметрами подключения.
Сохраняйте Requests в работающей синхронной интеграции, если она укладывается в требования. Выбирайте HTTPX, когда нужны HTTP/2 либо близкий API для sync и async. Используйте aiohttp для asyncio-приложения, которому подходят ClientSession, WebSocket и серверная экосистема.
Если вы начинаете с HTTP, сначала разберите GET, POST и Response в Requests. При выборе ради скорости проведите сравнимый тест на своей нагрузке и учитывайте успешность запросов.
Для простого синхронного скрипта выбирайте Requests. Если нужны и sync, и async, подойдёт HTTPX, а для полностью асинхронного клиента берите AIOHTTP. В региональном парсинге исходящий IP выбирают отдельно: библиотека управляет запросами, а прокси задаёт маршрут. Для проверки публичных страниц из нужной страны подойдут резидентские прокси ProxyWing, а с промокодом скидка на них будет пожизненной.
Статью написал:
Фулстек AI-инженер
Александр привносит в инженерную команду Proxywing глубокую фулстек-экспертизу — от архитектуры бэкенда и оптимизации производительности до AI-ориентированных процессов разработки. Его практический опыт охватывает Node.js, React, облачную инфраструктуру и RAG-пайплайны, что позволяет одинаково уверенно работать как с внутренней логикой прокси-платформы, так и с пользовательской частью продукта. В Proxywing Александр сосредоточен на проектировании отказоустойчивых систем, устранении узких мест производительности и внедрении современных AI-инструментов в процесс разработки. Вне кода он увлечён исследованием передовых подходов в AI-инженерии и созданием сайд-проектов, расширяющих технические горизонты.
Все статьи автора (58)