

WEB-прокси для Telegram: что это, где взять и как подключить
19.10.2026 6 мин
Requests отправляет HTTP-запросы из Python и возвращает объект Response. Начните с GET и POST, затем добавьте параметры URL, JSON, файлы и Session. Во всех сетевых примерах ниже задан timeout и проверяется HTTP-статус.
Примеры используют учебный echo-сервис httpbin: он возвращает полученные параметры и данные. Передавайте ему только демонстрационные значения. Requests выполняет синхронные запросы и не исполняет JavaScript страницы.
Response.json= и форму через data=.files= без ручного multipart-заголовка.Session.Библиотека Requests работает как сторонний HTTP-клиент Python. Функции get(), post(), put(), patch() и delete() отправляют запросы с соответствующим методом. Поведение ресурса определяет API сервера.
Результат вызова хранится в объекте Response. В нём доступны статус, заголовки и тело. Ответ есть и у GET, и у POST; сервер может вернуть пустое тело, HTML, JSON или другой формат.
Requests подходит для синхронного скрипта или интеграции с API. Для асинхронного приложения изучите различия Requests, HTTPX и aiohttp.
В терминале окружения проекта выполните:
python -m pip install requests
python -c "import requests; print(requests.__version__)"
Создайте файл demo.py. Не называйте его requests.py, иначе он может перекрыть установленную библиотеку.
import requests

response = requests.get("https://httpbin.org/get", timeout=(3, 10))
response.raise_for_status()
print("Статус:", response.status_code)
print("Тип:", response.headers.get("Content-Type"))
print("URL:", response.url)
print("Параметры:", response.json()["args"])
Запустите python demo.py. При успешном ответе появятся HTTP-статус 200, тип JSON и пустой словарь параметров. Если импорт не работает, проверьте пакет командой python -m pip show requests в том же окружении.
import requests

response = requests.get(
    "https://httpbin.org/get",
    params={"q": "python requests", "page": 2},
    timeout=(3, 10),
)
response.raise_for_status()
print(response.url)
print(response.json()["args"])
Requests кодирует параметры и добавляет их к URL. В args будут q и page; query-параметры приходят на сервер как строки. Дополнительные примеры GET из терминала есть в гайде по cURL GET.
import requests

response = requests.post(
    "https://httpbin.org/post",
    json={"name": "Tom", "age": 25},
    timeout=(3, 10),
)
response.raise_for_status()
print(response.json()["json"])
Поле json в ответе повторит отправленный объект. json= сериализует Python-объект и задаёт Content-Type: application/json. HTTP-статус 201 при создании ресурса зависит от API; учебный echo-сервис обычно возвращает 200.
PUT обычно заменяет представление ресурса, PATCH изменяет его часть, DELETE запрашивает удаление. Следующий пример показывает синтаксис: учебный сервис возвращает сведения о полученном запросе и не меняет реальные записи:
import requests

with requests.Session() as session:
    put = session.put("https://httpbin.org/put",
                      json={"name": "Tom", "age": 26}, timeout=(3, 10))
    put.raise_for_status()
    patch = session.patch("https://httpbin.org/patch",
                          json={"age": 27}, timeout=(3, 10))
    patch.raise_for_status()
    delete = session.delete("https://httpbin.org/delete", timeout=(3, 10))
    delete.raise_for_status()
    print(put.json()["json"], patch.json()["json"], delete.status_code)
На рабочем API проверьте его контракт и права перед вызовом методов изменения данных.
params= добавляет значения в URL, headers= задаёт HTTP-заголовки. Эти аргументы решают разные задачи:
import requests

response = requests.get(
    "https://httpbin.org/get",
    params={"tag": ["python", "http"]},
    headers={"Accept": "application/json", "User-Agent": "ExampleApp/1.0"},
    timeout=(3, 10),
)
response.raise_for_status()
print(response.json()["args"])
print(response.request.headers["User-Agent"])
Список создаёт несколько query-параметров с одним именем. response.request.headers содержит отправленные заголовки, response.headers содержит заголовки ответа.
Для GET без тела заголовок Content-Type обычно не нужен. Accept сообщает, какой формат ответа ожидает клиент. Заголовок Authorization задавайте по требованиям API и не выводите в журнал.
| Выражение | Результат |
|---|---|
response.status_code |
Числовой HTTP-статус |
response.headers |
Заголовки ответа |
response.text |
Тело как строка с учётом кодировки |
response.content |
Тело как байты |
response.json() |
Разобранный JSON: объект, список или другое JSON-значение |
response.raise_for_status() |
Исключение HTTPError для 4xx/5xx |
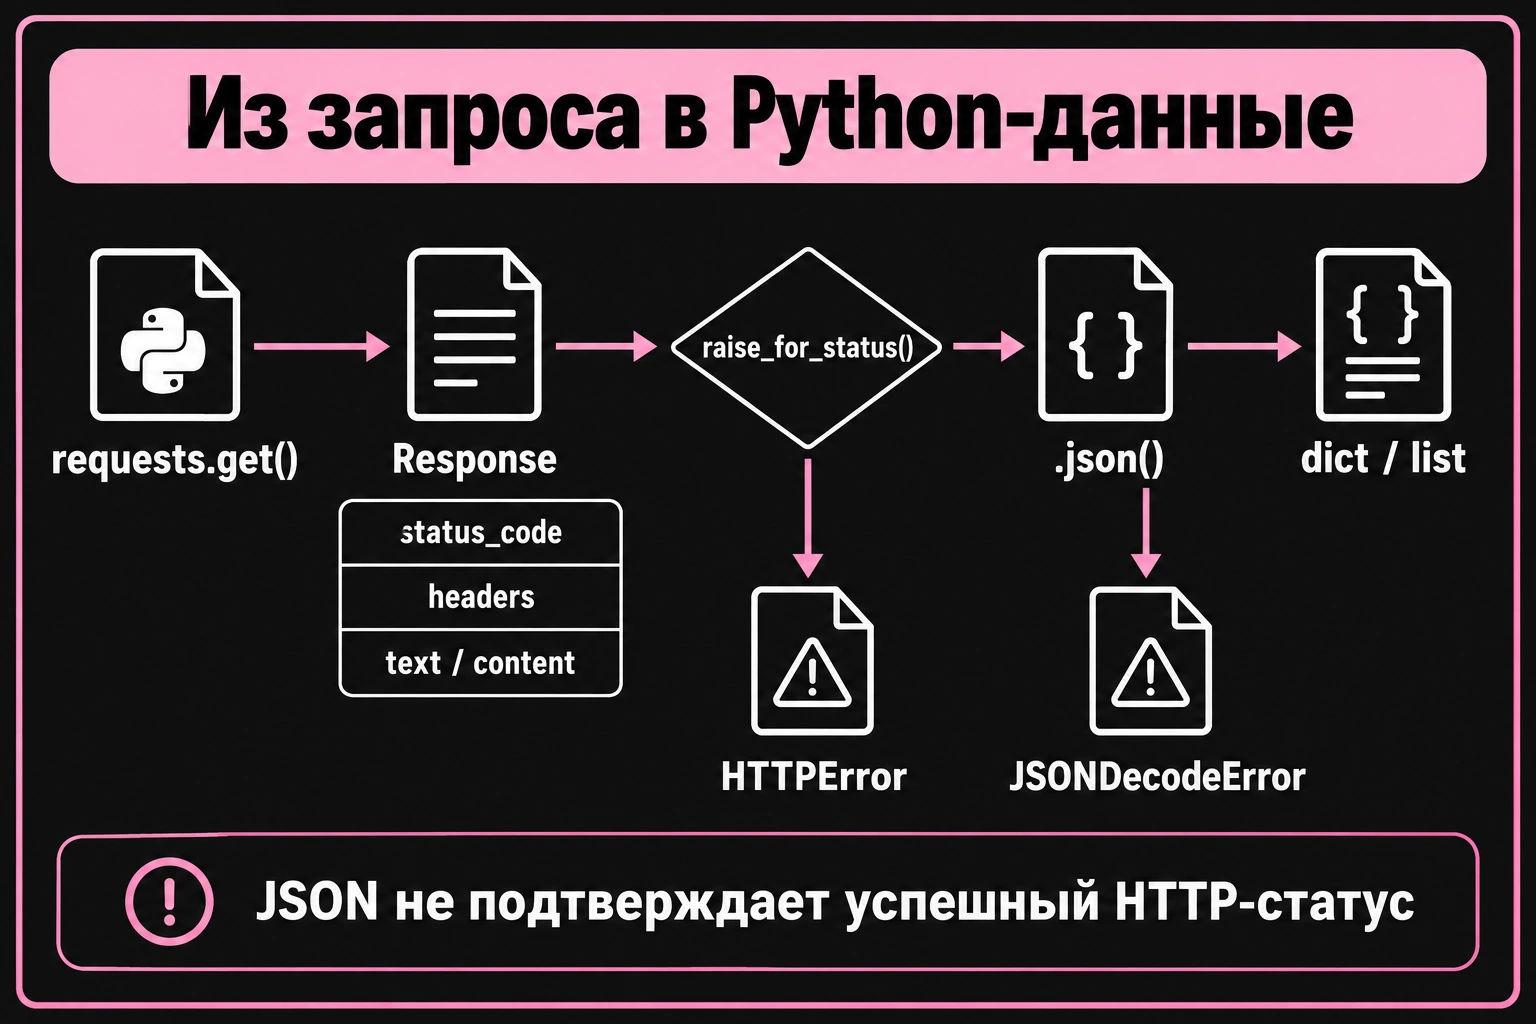
Перед чтением JSON проверьте статус. Успешный вызов .json() означает, что тело разобрано; HTTP-ошибка тоже может содержать JSON.
import requests

response = requests.get("https://httpbin.org/json", timeout=(3, 10))
response.raise_for_status()
try:
    data = response.json()
except requests.exceptions.JSONDecodeError:
    print("Ответ не содержит корректный JSON")
else:
    print(type(data).__name__)
У ответа 204 тело отсутствует. Не вызывайте .json() без проверки, если API допускает такой результат.
import requests

response = requests.post(
    "https://httpbin.org/post",
    data={"name": "Tom", "role": "reader"},
    timeout=(3, 10),
)
response.raise_for_status()
print(response.json()["form"])
Словарь в data= передаётся как форма application/x-www-form-urlencoded. Для JSON используйте json=. Если переданы data или files, не рассчитывайте на одновременную отправку отдельного объекта json.
Поместите свой учебный файл report.pdf в текущую папку. Контекст with закроет файл после запроса:
import requests

with open("report.pdf", "rb") as file:
    response = requests.post(
        "https://httpbin.org/post",
        data={"category": "demo"},
        files={"file": ("report.pdf", file, "application/pdf")},
        timeout=(3, 20),
    )
response.raise_for_status()
print(response.json()["form"])
print(list(response.json()["files"]))
Requests создаёт multipart/form-data и его boundary автоматически. Не задавайте этот Content-Type вручную, иначе заголовок может разойтись с телом. Обычная передача через files= не гарантирует потоковую загрузку огромного файла без буферизации.
import requests

try:
    response = requests.get("https://httpbin.org/get", timeout=(3, 10))
    response.raise_for_status()
    data = response.json()
except requests.exceptions.Timeout:
    print("Истёк сетевой таймаут")
except requests.exceptions.HTTPError as exc:
    print("HTTP-статус:", exc.response.status_code)
except requests.exceptions.JSONDecodeError:
    print("В теле ответа нет корректного JSON")
except requests.exceptions.RequestException as exc:
    print("Ошибка запроса:", type(exc).__name__)
else:
    print(data["url"])
Первое число в timeout=(3, 10) ограничивает подключение, второе ограничивает ожидание данных при чтении. Общая загрузка может длиться дольше их суммы. Requests не задаёт сетевой таймаут автоматически.
Повторы POST требуют отдельного решения: сервер мог выполнить действие до обрыва ответа. Примеры конечной политики повторов и общей настройки описаны в статье о таймаутах Requests.
Session сохраняет cookies, общие заголовки и пул соединений. Используйте один объект для связанной серии запросов:
import requests

with requests.Session() as session:
    session.headers.update({"User-Agent": "ExampleApp/1.0"})
    first = session.get(
        "https://httpbin.org/cookies/set/theme/dark", timeout=(3, 10)
    )
    first.raise_for_status()
    second = session.get("https://httpbin.org/cookies", timeout=(3, 10))
    second.raise_for_status()
    print(second.json()["cookies"])
    print(session.cookies.get_dict())
В выводе ожидается cookie theme со значением dark. Сервер установил её в первом ответе, сессия отправила её следующему подходящему запросу. Этот пример не выполняет вход в реальный аккаунт.
Соединение может быть использовано повторно для того же хоста, если сервер поддерживает keep-alive, а ответ прочитан или закрыт. Открытое соединение не сохраняется бессрочно.
На рабочем API считывайте токен из защищённой конфигурации. Для учебного httpbin используйте только демонстрационный токен:
import requests

response = requests.get(
    "https://httpbin.org/bearer",
    headers={"Authorization": "Bearer demo-token"},
    timeout=(3, 10),
)
response.raise_for_status()
print(response.json()["authenticated"])
Ответ покажет, что заголовок получен. Он не проверяет реальные права в стороннем сервисе.
Схема пагинации зависит от сервиса: номер страницы, cursor или next URL. Функция ниже применима только к API, где есть массив items, а пустой массив завершает выдачу:
def collect_pages(session, url, max_pages=100):
    results = []
    for page in range(1, max_pages + 1):
        response = session.get(url, params={"page": page}, timeout=(3, 10))
        response.raise_for_status()
        payload = response.json()
        items = payload.get("items")
        if not isinstance(items, list):
            raise ValueError("Ожидался массив items")
        if not items:
            return results
        results.extend(items)
    raise RuntimeError("Достигнут предел страниц; проверьте пагинацию API")
Передайте функции свою Session и URL разрешённого API. Предельное число страниц защищает от бесконечного обхода при неверном контракте или повторении одной страницы.
| Проблема | Первое действие |
|---|---|
ModuleNotFoundError |
Установите Requests через python -m pip в используемое окружение |
| Ошибка импорта из собственного файла | Переименуйте requests.py и проверьте путь импорта |
JSONDecodeError |
Проверьте статус, Content-Type и наличие тела |
| HTTP 401 | Проверьте срок и формат токена |
| HTTP 403 | Проверьте права и причину запрета в ответе |
| HTTP 429 | Снизьте частоту, учитывайте Retry-After |
SSLError |
Проверьте доверенный CA, имя узла и системное время |
| Прокси не применяется | Проверьте proxies, окружение и схему целевого URL |
Для прокси используйте отдельную инструкцию по HTTP, SOCKS5 и авторизации в Requests. Проверку TLS сохраняйте включённой.
Задавайте таймауты и проверяйте HTTP-статус. Закрывайте файлы, потоковые ответы и сессии контекстом with. Разделяйте ошибки сети, HTTP и формата данных. Храните секреты отдельно от исходников и не выводите их в журнал.
Соблюдайте лимиты сервиса. Для отдельного выхода в сеть выберите индивидуальные прокси ProxyWing, затем проверьте маршрут на одном запросе. Подключение прокси не отменяет правила целевого API.
Проверьте один GET и один POST на учебных данных. Затем перенесите вызовы на свой API по его контракту: выберите params, json или data, проверьте тип ответа и добавьте нужную авторизацию. Для связанной серии запросов используйте Session.
Статью написал:
Фулстек AI-инженер
Александр привносит в инженерную команду Proxywing глубокую фулстек-экспертизу — от архитектуры бэкенда и оптимизации производительности до AI-ориентированных процессов разработки. Его практический опыт охватывает Node.js, React, облачную инфраструктуру и RAG-пайплайны, что позволяет одинаково уверенно работать как с внутренней логикой прокси-платформы, так и с пользовательской частью продукта. В Proxywing Александр сосредоточен на проектировании отказоустойчивых систем, устранении узких мест производительности и внедрении современных AI-инструментов в процесс разработки. Вне кода он увлечён исследованием передовых подходов в AI-инженерии и созданием сайд-проектов, расширяющих технические горизонты.
Все статьи автора (58)