

WEB-прокси для Telegram: что это, где взять и как подключить
19.10.2026 6 мин
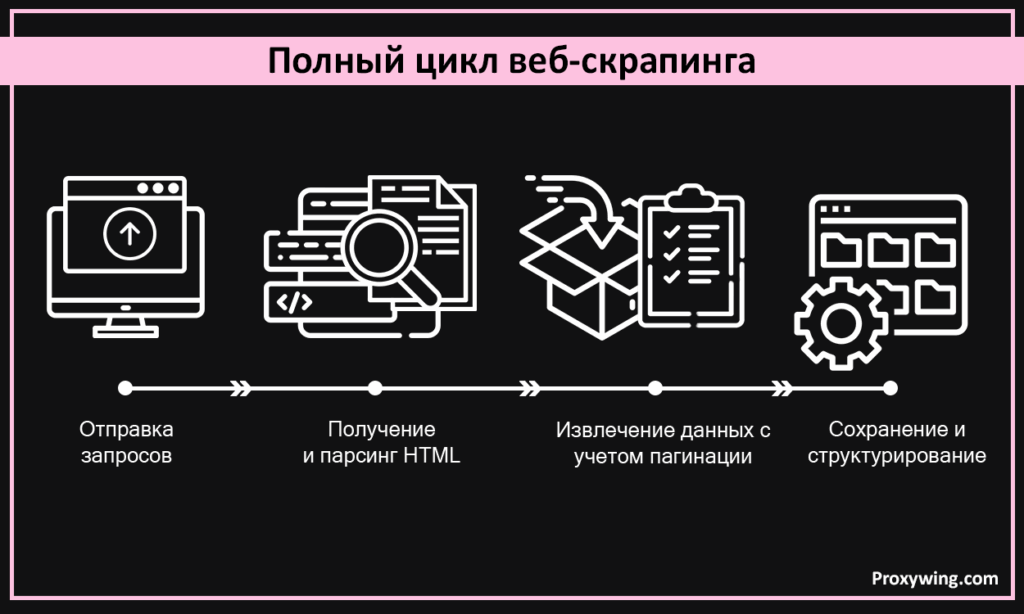
Веб-скрапинг, или скрейпинг, это автоматизированный сбор данных со страниц сайта. Программа загружает страницу, извлекает нужные поля и сохраняет их в таблицу, JSON или базу данных. Например, так можно собирать названия товаров, цены и наличие для дальнейшего сравнения.
Для проекта сначала определяют источники, нужные поля и частоту обновления. Затем выбирают способ загрузки страниц, проверяют качество выгрузки и условия использования данных.
Что такое веб-скрапинг? Это процесс автоматического извлечения информации с сайта или любой другой онлайн-платформы с помощью специализированного софта — веб-скраперов. Такая автоматизация позволяет бизнесу и аналитикам получать огромные массивы данных без необходимости копировать что-либо вручную.
Инструмент заходит на целевой сайт. Читает HTML-код. Находит нужные сведения. А затем сохраняет их в чистом, удобном формате: CSV, JSON или сразу в базу данных. Информация, полученная таким путем, проходит очистку и отправляется в работу. Спектр задач широк: от тренировки ИИ и мониторинга прайсов до глубокого анализа конкурентов, новостной повестки и рыночных тенденций.
Скрапер получает страницу и извлекает поля по заданным правилам: например, название из заголовка карточки и цену из соответствующего элемента. Если разметка изменилась, правило может вернуть пустое или неверное значение. Поэтому в процесс включают проверку результата.
Когда данные появляются только после выполнения JavaScript, простой HTTP-запрос может вернуть страницу без нужных полей. Сначала проверьте доступность официального API, затем выбирайте инструмент загрузки.
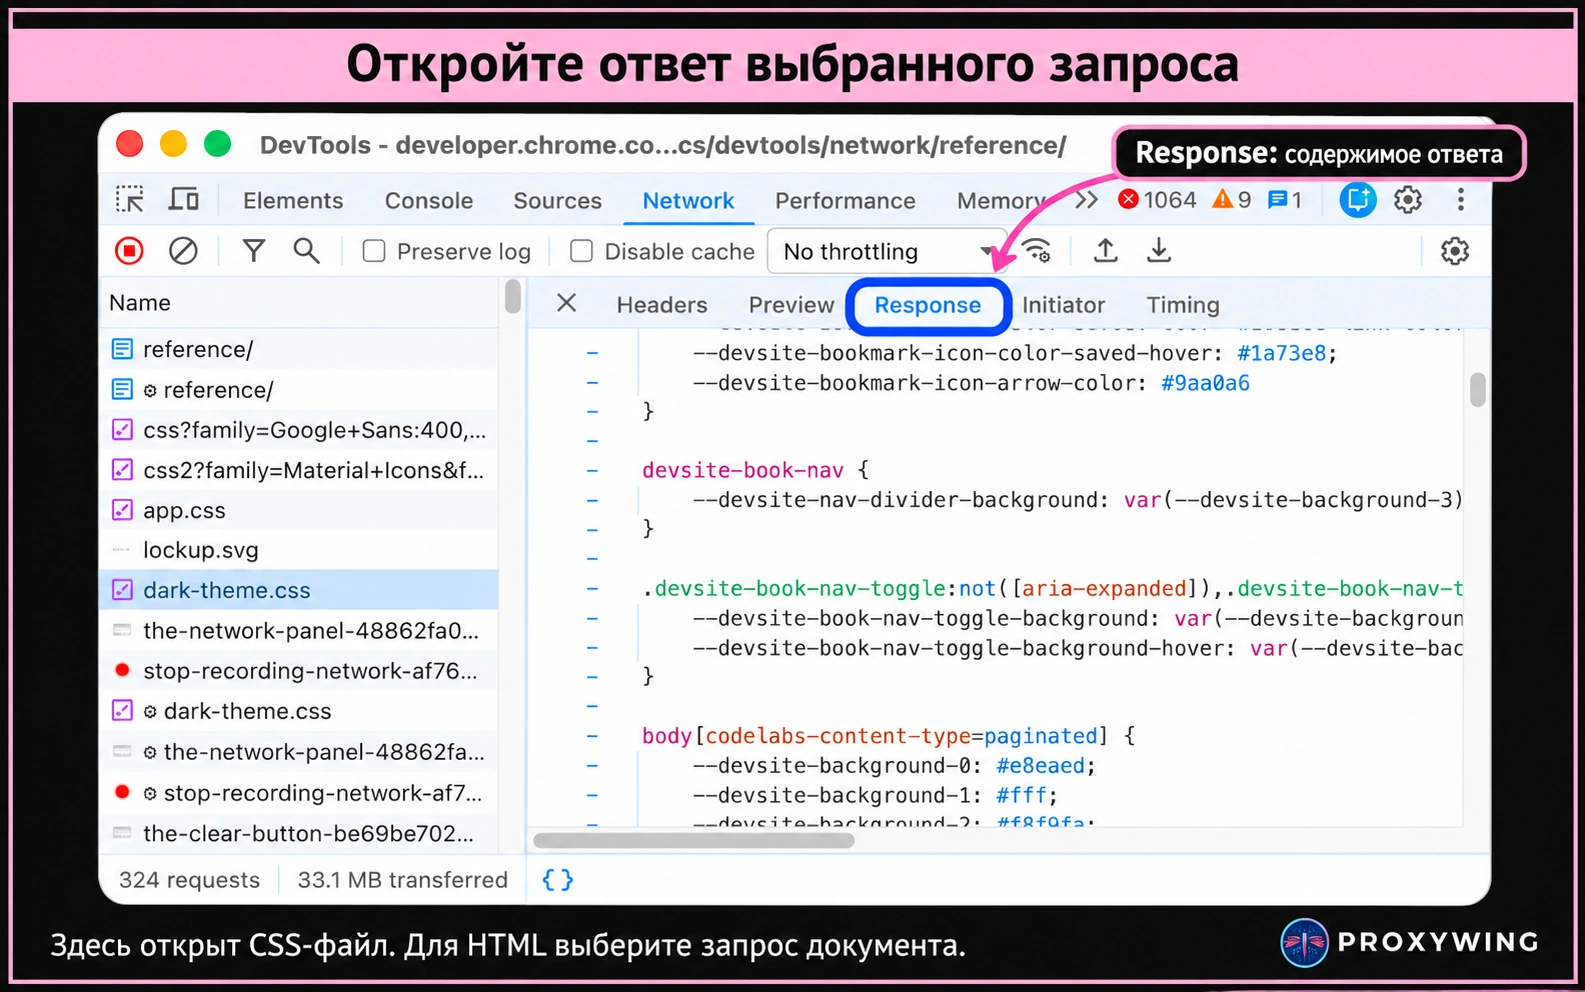
Чтобы увидеть, что браузер получил от сервера, откройте инструменты разработчика: Network («Сеть») → нужный запрос → Response («Ответ»). Для HTML выберите запрос документа, для данных API – соответствующий Fetch/XHR-запрос. Проверьте, есть ли нужное поле в ответе.
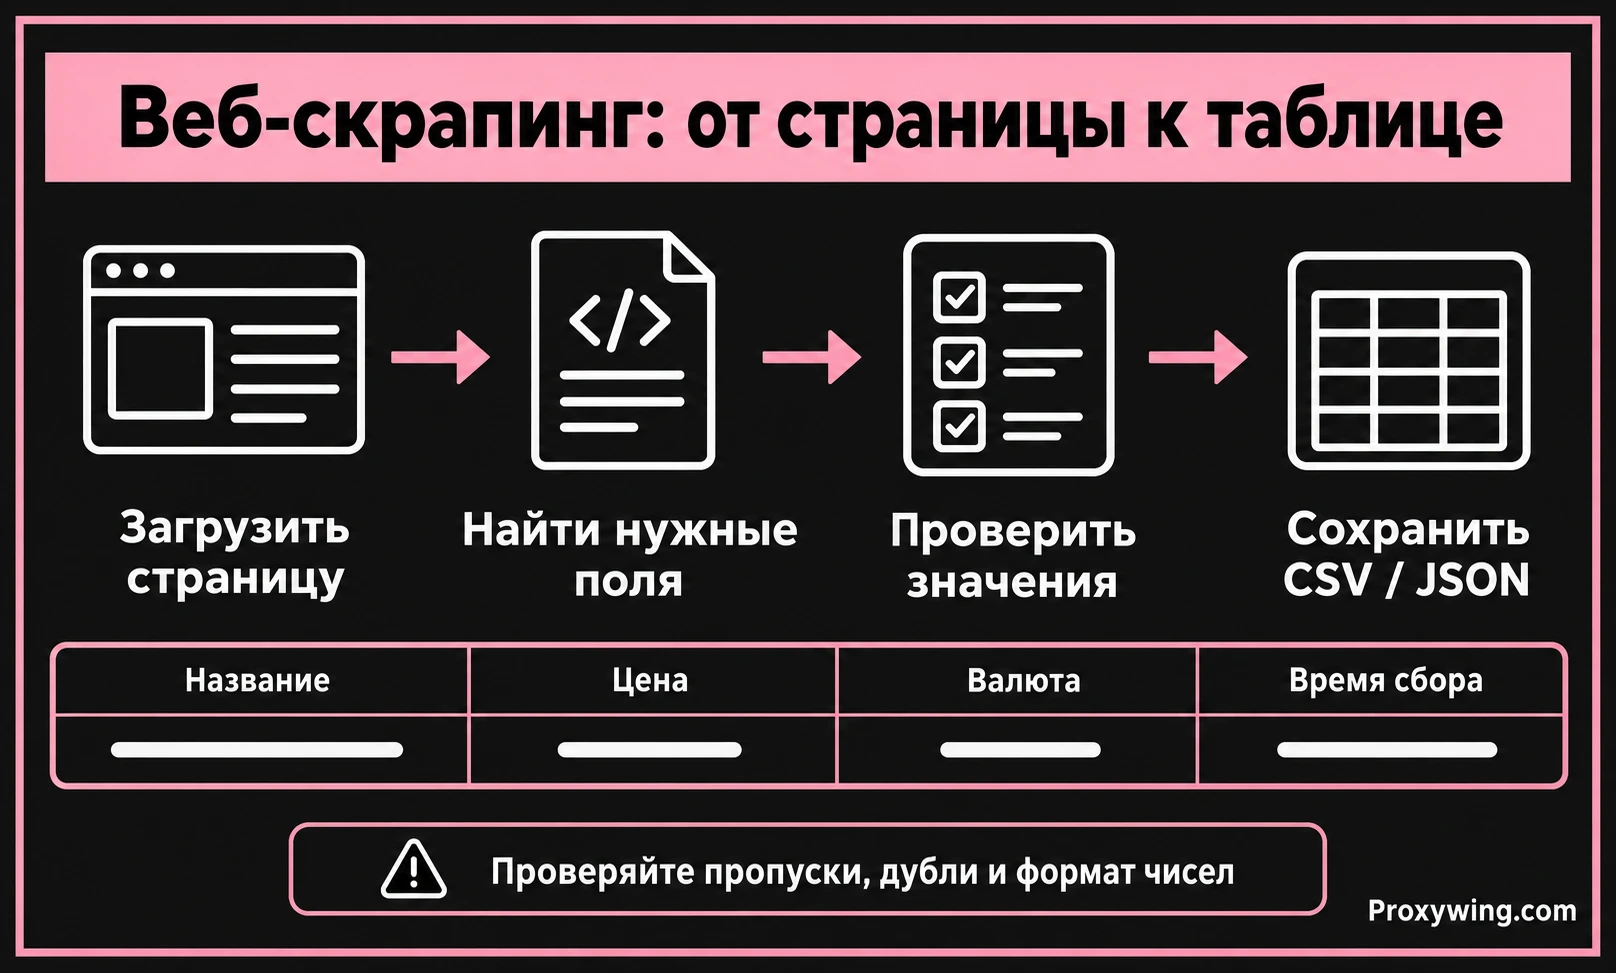
Допустим, на учебной странице указаны название «Товар A», цена «1 290 ₽» и наличие «Есть». После извлечения запись можно привести к такому виду:
| Поле | Значение |
|---|---|
| Название | Товар A |
| Цена | 1290 |
| Валюта | RUB |
| Наличие | Есть |
Это условные данные для примера. В рабочей выгрузке добавьте URL и время проверки, а цену по акции отделите от обычной. Пустое поле цены сохраните как пропуск: значение 0 исказит сравнение.
| Операция | Что делает | Пример результата |
|---|---|---|
| Краулинг | Находит страницы и переходит по ссылкам | Список URL карточек товаров |
| Парсинг | Разбирает структуру документа и выбирает поля | Название и цена из HTML карточки |
| Скрапинг | Собирает нужные данные с сайта, объединяя загрузку, извлечение и сохранение | Таблица товаров с ценами и временем проверки |
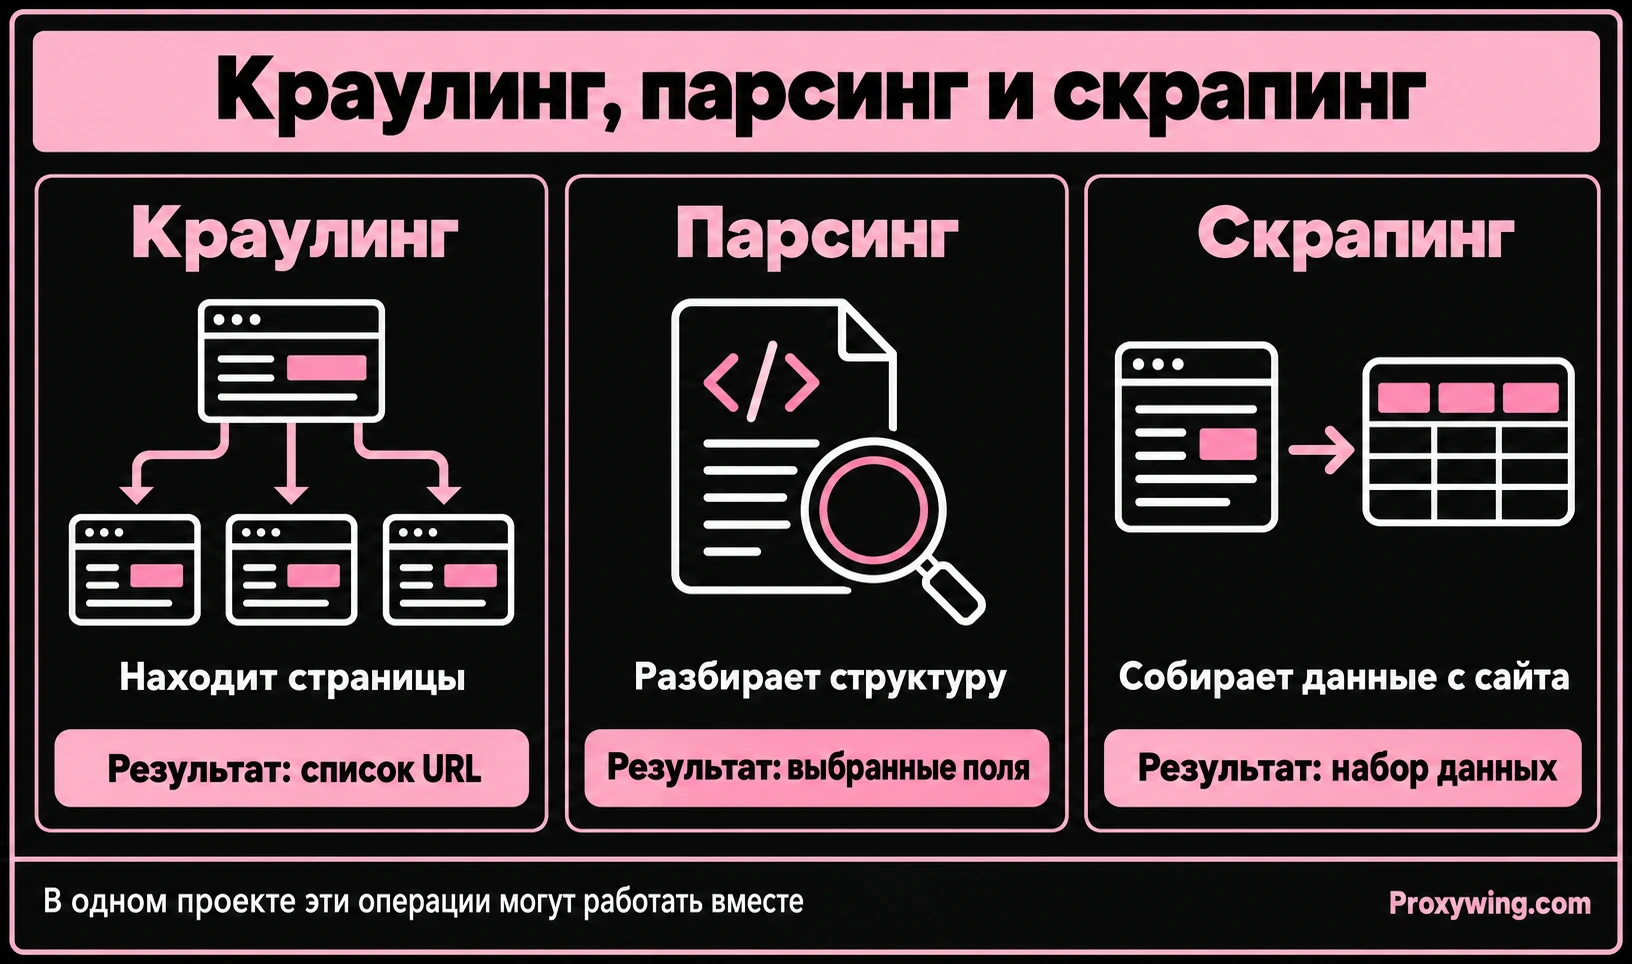
В русскоязычной практике «парсингом сайта» часто называют весь процесс сбора. При постановке задачи уточните результат: только список страниц, выбранные поля или готовая регулярно обновляемая таблица. Это поможет согласовать объем работ.
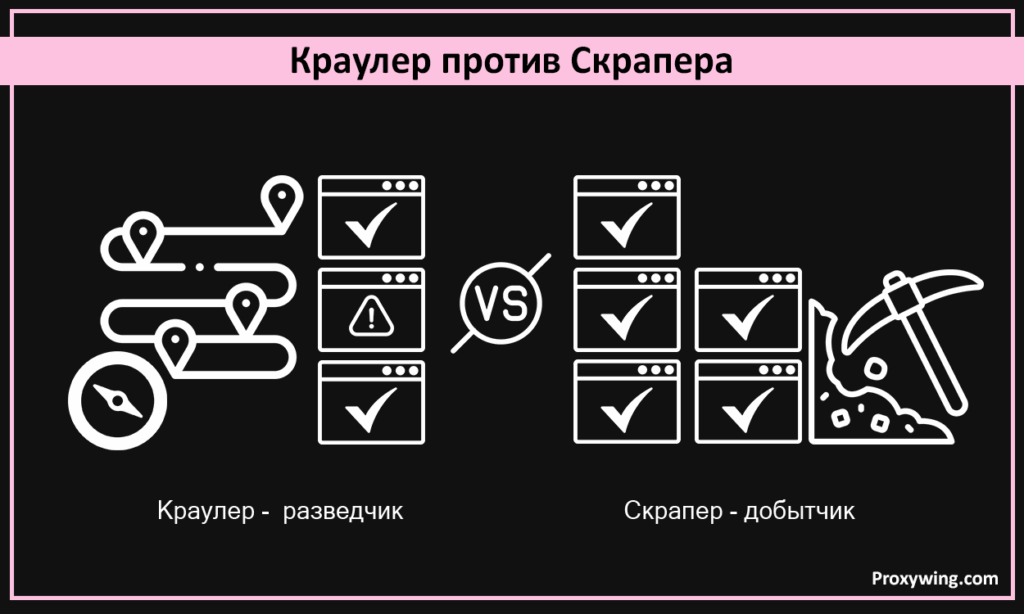
Современные инструменты для парсинга классифицируются в зависимости от того, как они созданы и где развернуты. Давайте рассмотрим самые популярные варианты.
Здесь выбор стоит между самописными решениями и готовыми инструментами. В чем разница?
Выбор между кастомным и готовым решением зависит от задачи, технической экспертизы команды и срочности. Если нужно построить сложную систему под специфические нужды — пишите свой код на Python.
В этой категории есть три опции: расширения для браузера, десктопный софт и API-решения.
Здесь мы выделяем два типа: локальные скрипты и облачные скраперы.
В Python есть отдельные инструменты для HTTP-запросов, разбора HTML и обхода страниц. Их можно объединить под нужный формат выгрузки.
Вот главные инструменты в экосистеме Python:
Библиотека помогает разобрать документ, но правила извлечения и проверки полей задает разработчик. После изменения сайта эти правила нужно проверить повторно.
У этой технологии множество применений в реальном мире. Она работает в самых разных индустриях. Вот наиболее распространенные сценарии:
Бизнес и аналитики отслеживают стоимость товаров на десятках сайтов одновременно. Собранные данные становятся фундаментом стратегии. Это позволяет оставаться конкурентоспособным, мгновенно корректировать ценовую тактику и видеть изменения рынка в режиме реального времени.
Для исследования рынка собирают ассортимент, характеристики, цены и доступные отзывы. Сравнивать нужно сопоставимые товары и периоды: различия в комплектации, регионе и условиях доставки могут изменить выводы.
Организации и маркетологи аккумулируют статьи, посты и апдейты из разных источников, чтобы держать руку на пульсе или наполнять контент-агрегаторы. Данные собираются из множества каналов, а затем анализируются алгоритмами машинного обучения. Цель — выудить самые ценные инсайты.
Тексты отзывов и публикаций можно использовать для анализа отношения к продукту. Выборка и ошибки модели влияют на результат. Перед выводами проверьте дубли, язык, контекст и точность классификации на размеченных примерах.
Каталоги могут содержать названия компаний, направления работы и опубликованные контакты. Перед переносом таких данных в CRM определите допустимую цель обработки, срок хранения и применимые ограничения на использование контактов.
Правила зависят от страны, источника, состава данных и цели обработки. Публично доступные персональные данные могут сохранять правовую защиту.
Перед проектом зафиксируйте:
Проверьте robots.txt и указания владельца. Этот файл описывает правила для роботов; право на повторное использование контента устанавливается отдельно. Для коммерческого проекта с персональными данными или неясными правами согласуйте схему сбора и использования с юристом.
Регулярная выгрузка помогает сравнивать цены, наличие и изменения контента в одном формате. Повторные запуски сокращают ручное копирование, если правила извлечения остаются рабочими.
При расчете затрат учитывайте разработку, инфраструктуру, проверку качества и поддержку после изменений сайта. До масштабирования проведите небольшую выборку: посчитайте долю заполненных полей, дублей и ошибок, затем оцените стоимость полезной записи.
Несмотря на плюсы, веб-скрапинг — это полоса препятствий. О трудностях нужно знать заранее.
Задайте задержку и число одновременных запросов к одному сайту. При ответе 429 учитывайте Retry-After, если он есть, и снижайте частоту. При 403, CAPTCHA или требовании войти остановите автоматический сбор и проверьте условия доступа. Для устойчивой выгрузки запросите API или согласованный канал данных.
Сайты меняют верстку. Часто. Это ломает настройки скрапера. В итоге вы получаете ошибки или битые данные.
Для каждой выгрузки сохраните число обработанных URL, долю пустых полей и число дублей. На небольшой случайной выборке сравните значения с исходными страницами. Отдельно проверяйте валюту, единицы измерения и дату обновления: ошибку формата легко принять за изменение цены.
Соблюдайте правила. Не трогайте сайты, запрещающие доступ ботам. Собирайте только то, что лежит в открытом доступе. Уважайте авторские права.
Прокси используют, когда требуется проверить региональную версию сайта или направить разрешенные запросы через определенный адрес. Для последовательности действий с одной сессией важно учитывать срок закрепления IP.
Если парсинг вам не подходит, есть и другие пути получения информации:
API скрапинг-сервиса может продолжать собирать HTML за вас. При выборе выясните, откуда получены данные и какие ограничения действуют.
Начните с небольшого списка страниц и заранее заданных полей. Проверьте условия доступа, сравните выгрузку с источником и настройте контроль ошибок. После этого можно оценить затраты на регулярный сбор и выбрать подходящую инфраструктуру.
Для региональных проверок выберите резидентские прокси ProxyWing. Сверьте доступные страны, условия сессии и объем трафика с задачей. Лимиты целевого сайта соблюдайте для всего проекта, включая запросы через разные адреса.
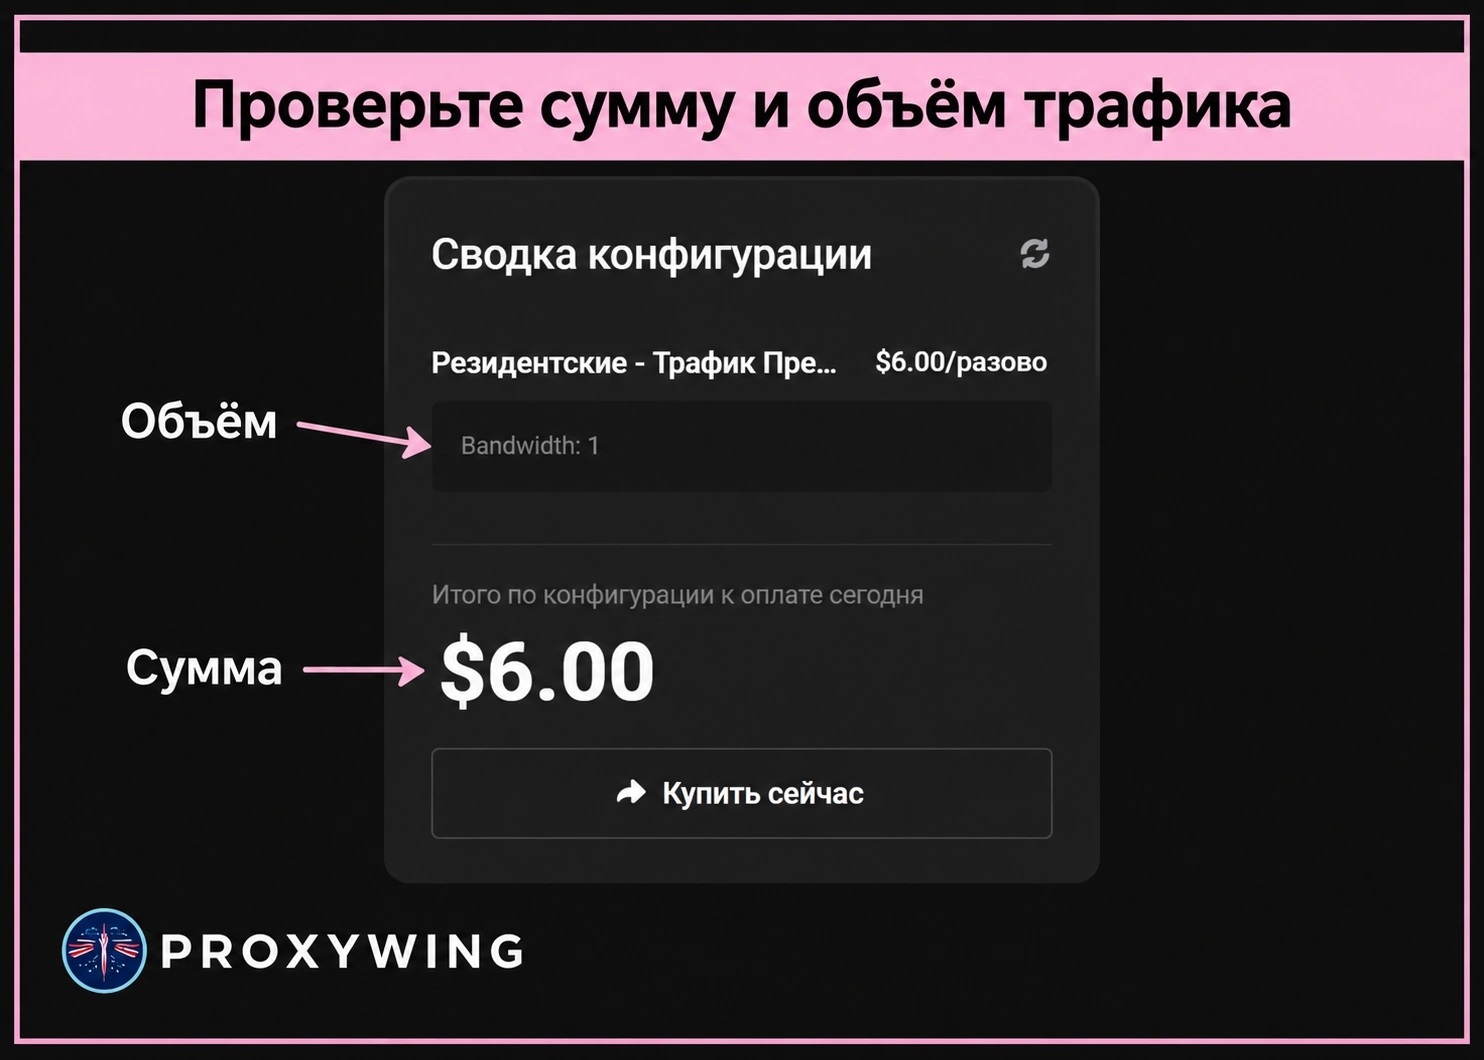
После выбора продукта проверьте параметры заказа в сводке конфигурации.
Статью написал:
Генеральный директор
Даниил основал Proxywing с чётким видением: предоставлять премиальные прокси-решения, на которые бизнес и частные пользователи могут положиться без компромиссов. Его экспертиза в международном бизнесе и B2B-стратегии обеспечивает расширение компании на рынки ЕС, США и Азии, а практический подход гарантирует, что качество продукта — от 99% аптайма до оперативной поддержки — остаётся главным приоритетом. Даниил мыслит масштабно: совершенствует внутренние процессы компании, выявляет рыночные возможности и внедряет передовые технологии, чтобы оставаться впереди конкурентов. Когда он не занят развитием компании, то направляет энергию на изучение новых бизнес-направлений и стратегических партнёрств.
Все статьи автора (63)Да. Сайт может учитывать частоту запросов, поведение сессии и другие признаки автоматизации. Прокси меняет сетевой адрес, но не гарантирует доступ. Соблюдайте лимиты и используйте согласованный способ получения данных.
Для учебного проекта подходят библиотеки с открытым исходным кодом, например Requests и Beautiful Soup, или фреймворк Scrapy. Выбирайте источник, который разрешает такие проверки. Учитывайте затраты на запуск и поддержку.
Сначала проверьте официальный API или выгрузку с понятной лицензией. Для другого способа сбора оцените условия источника, права на данные и применимые требования к персональной информации.
Выбор велик. JavaScript (Node.js), Ruby, PHP, Go и Java. У всех есть мощные библиотеки для написания парсеров.
Скрапинг получает данные со страниц сайта. Data mining ищет закономерности в уже собранных наборах. Выгрузку со скрапера сначала проверяют и очищают, затем передают на анализ.