

WEB-прокси для Telegram: что это, где взять и как подключить
19.10.2026 6 мин
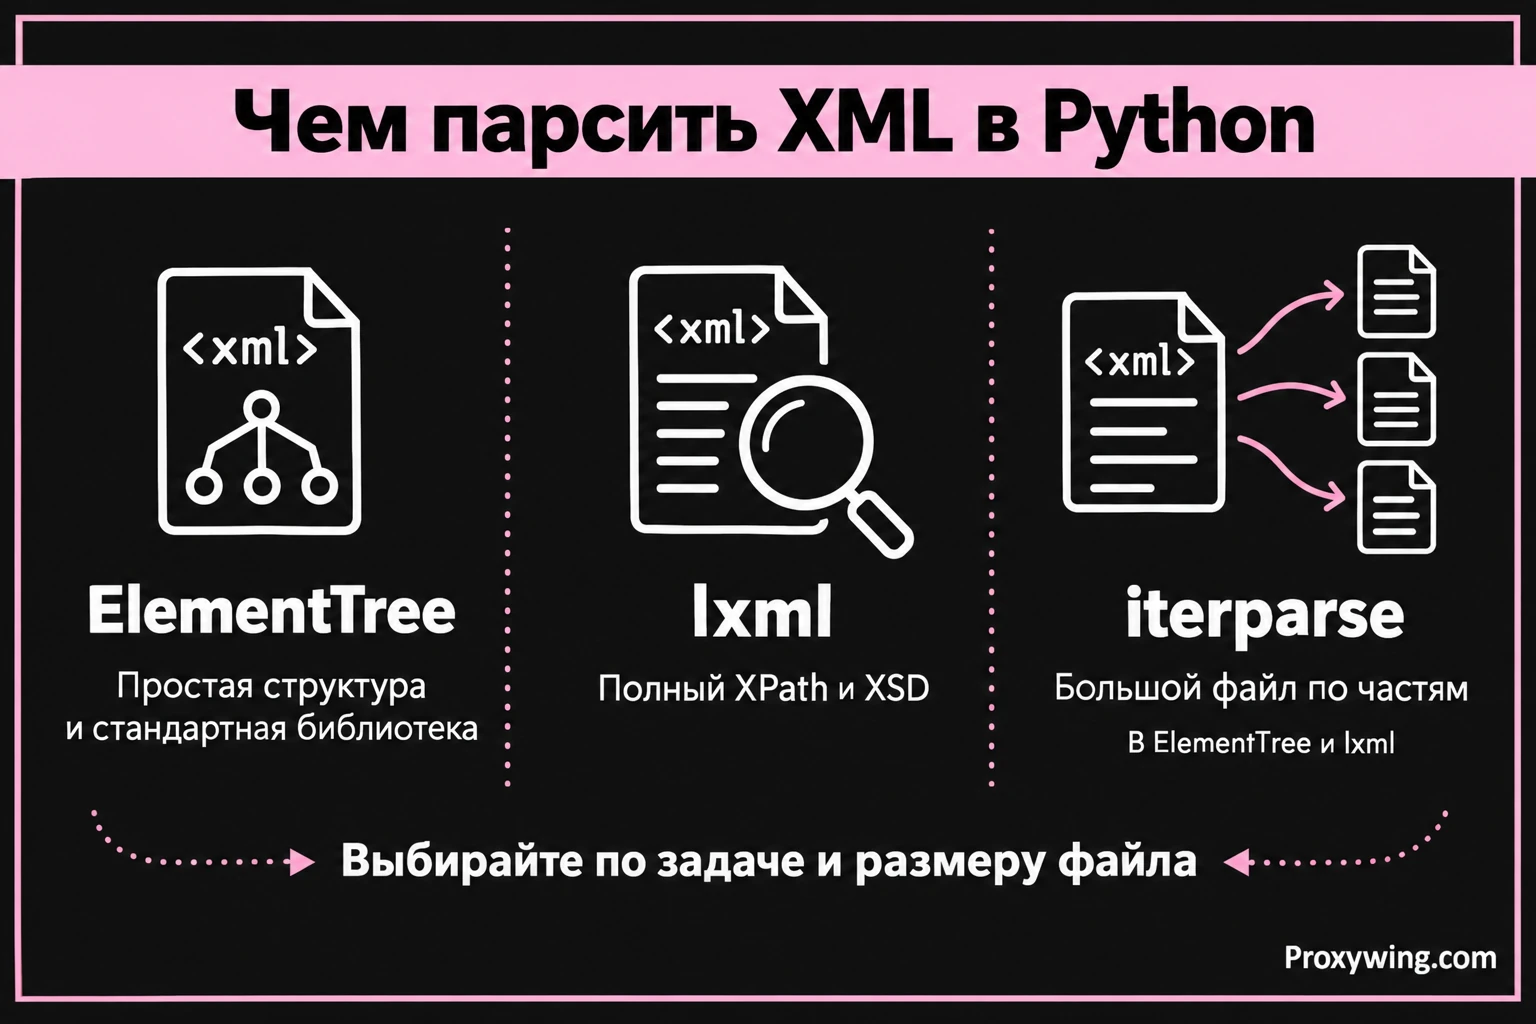
Для чтения небольшого XML-файла в Python обычно достаточно xml.etree.ElementTree. Для XPath 1.0 и XSLT подходит lxml. Ниже приведены примеры чтения, поиска, изменения и сохранения XML, а также разбор больших файлов и недоверенного ввода.
Примеры рассчитаны на Python 3. Вначале создаётся учебный файл catalog.xml. Последующие операции с файлом используют его в текущей папке. Фрагменты с XML-строкой выполняются самостоятельно.
| Задача | Подход |
|---|---|
| Прочитать небольшой корректный документ | ElementTree |
| Выполнить XPath 1.0 или XSLT | lxml |
| Обработать большой файл по записям | iterparse с освобождением узлов или SAX |
| Принять XML от пользователя | Ограничить размер и использовать защитные настройки парсера |
| Изменить и сохранить дерево | ElementTree или lxml |
ElementTree поддерживает ограниченное подмножество XPath. Метод xpath есть у lxml; переносить его вызов на объект стандартного ElementTree нельзя.
XML встречается в выгрузках каталогов, конфигурациях и интеграциях. Он описывает вложенные элементы, атрибуты и текст. Пространства имён разделяют одинаковые имена из разных форматов, а схема XSD может задавать требования к структуре.
Парсинг строит представление документа. Проверка по схеме и проверка бизнес-правил выполняются отдельно. Успешное чтение XML ещё не подтверждает наличие нужных полей.
Запустите самостоятельный пример в отдельной рабочей папке. Он создаст или перезапишет catalog.xml и выведет данные двух книг:
from pathlib import Path
import xml.etree.ElementTree as ET

xml_text = """<?xml version="1.0" encoding="utf-8"?>
<catalog>
  <book id="b1"><title>Python</title><price>500</price></book>
  <book id="b2"><title>XML</title><price>300</price></book>
</catalog>
"""
Path("catalog.xml").write_text(xml_text, encoding="utf-8")
tree = ET.parse("catalog.xml")
root = tree.getroot()

for book in root.findall("book"):
    print(book.get("id"), book.findtext("title"), book.findtext("price"))
Результат:
b1 Python 500
b2 XML 300
get читает атрибут, findtext возвращает текст дочернего элемента. Числа из XML пока остаются строками.
ElementTree входит в стандартную библиотеку Python. Для lxml и defusedxml установите пакеты в окружение проекта:
python -m pip install lxml defusedxml
Используйте тот же интерпретатор, которым запускаете скрипт. Если система называет его python3, замените команду python. Это предотвращает ситуацию, когда пакет установлен в одном окружении, а код выполняется в другом.
Для catalog.xml из быстрого старта:
import xml.etree.ElementTree as ET

tree = ET.parse("catalog.xml")
root = tree.getroot()
print(root.tag)
Для самостоятельной XML-строки:
import xml.etree.ElementTree as ET

root = ET.fromstring("<catalog><book id='b1' /></catalog>")
print(root.find("book").get("id"))
parse возвращает ElementTree, fromstring возвращает корневой Element. Если XML получен как байты, передайте их парсеру без предварительного декодирования случайно выбранной кодировкой.
Этот пример использует catalog.xml:
import xml.etree.ElementTree as ET

root = ET.parse("catalog.xml").getroot()
book = root.find("book[@id='b1']")
if book is not None:
    print(book.findtext("title", default="Без названия"))

for title in root.findall(".//title"):
    print(title.text)
find возвращает первый подходящий элемент либо None. findall возвращает список. Проверяйте результат через is not None: логическое значение элемента с отсутствующими дочерними узлами может вводить в заблуждение.
Путь book ищет непосредственных детей корня. Путь .//title ищет потомков на любой глубине. Слишком широкий поиск может захватить одноимённые поля из других частей документа.
ElementTree хранит дерево и подходит для обычного чтения и изменения XML. xml.dom.minidom предоставляет DOM-представление и также загружает документ в память.
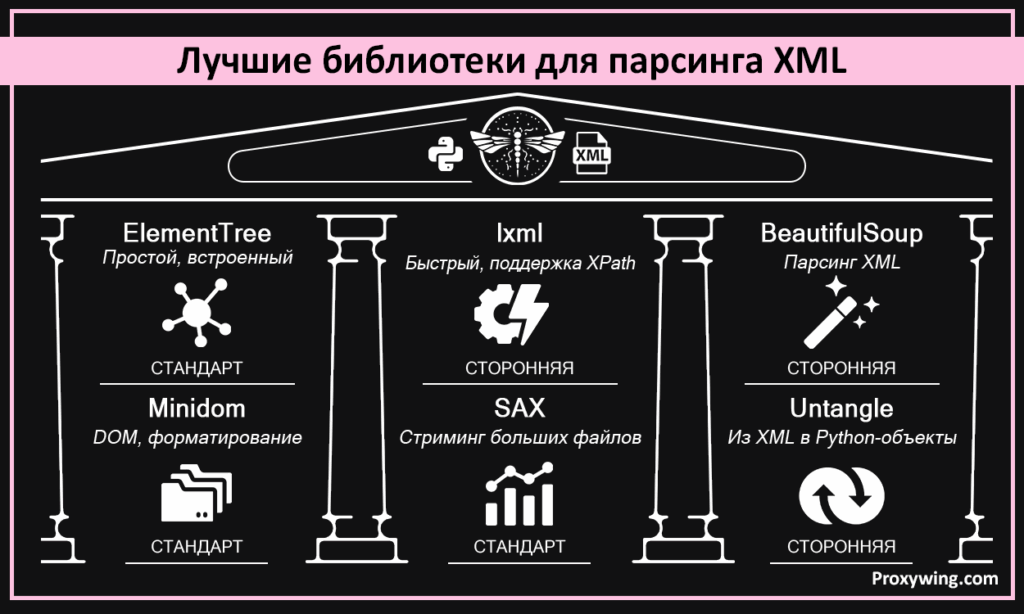
xml.sax вызывает обработчики событий по мере чтения. Он подходит, когда нужны отдельные значения без сохранения полного дерева. При этом обработчик сам должен хранить необходимое состояние и ограничивать накопление данных.
lxml предоставляет XPath 1.0, XSLT и проверку схем. Производительность зависит от структуры документа и запросов; выбор библиотеки стоит проверять на своих данных.
BeautifulSoup может работать с XML через соответствующий парсер. Попытка восстановить повреждённую разметку способна изменить структуру. Для обмена данными обычно полезнее отклонить неверный документ и исправить источник.
Библиотеки преобразования XML в объекты сокращают код доступа к полям, но требуют правил для повторяющихся тегов, атрибутов и смешанного текста. Для простого формата эти правила можно задать самостоятельно.
Размер XML на диске и размер дерева в памяти различаются. На память влияют число узлов, атрибуты, длина текста и дополнительные структуры, которые создаёт ваш код.
Замеряйте время и пиковую память на типичной выгрузке. Если после потокового чтения все результаты складываются в один список, память всё равно растёт вместе с объёмом данных.
Начните с ElementTree, если нужны поиск по простым путям, атрибуты и сохранение XML. Выберите lxml, если задача требует функций XPath, XSLT либо схем.
Для больших файлов сначала определите границу независимой записи. Например, одна книга может обрабатываться целиком и удаляться из памяти после чтения. Если вычисление зависит от всего документа, простого освобождения узлов будет недостаточно.
Пример использует catalog.xml из быстрого старта и установленный lxml:
from lxml import etree

parser = etree.XMLParser(
    resolve_entities=False,
    load_dtd=False,
    no_network=True,
)
tree = etree.parse("catalog.xml", parser)
titles = tree.xpath("/catalog/book[number(price) > 400]/title/text()")
print(titles)
Результат: [‘Python’].
| Выражение | Результат |
|---|---|
| /catalog/book | Книги непосредственно в catalog |
| //book | Все элементы book в документе |
| //book[@id=’b1′] | Книги с атрибутом id, равным b1 |
| //book/title/text() | Текст заголовков книг |
| count(//book) | Количество элементов book |
XPath описывает выборку. Он не отменяет обход структуры внутри реализации. Для повторяемого запроса в lxml можно заранее создать etree.XPath и использовать его для разных деревьев.
Namespace входит в полное имя элемента. Даже пространство имён по умолчанию нужно учитывать в запросе:
import xml.etree.ElementTree as ET

xml_text = '<catalog xmlns="urn:books"><book><title>Python</title></book></catalog>'
root = ET.fromstring(xml_text)
namespaces = dict(b="urn:books")
title = root.find("b:book/b:title", namespaces)
if title is not None:
    print(title.text)
Префикс b выбран для запроса. Он не обязан совпадать с префиксом в исходном документе, но URI должен совпадать точно. Запрос без namespace в этом примере не найдёт title.
В lxml словарь передаётся в xpath через параметр namespaces. Удалять пространство имён из XML ради упрощения запроса обычно не требуется.
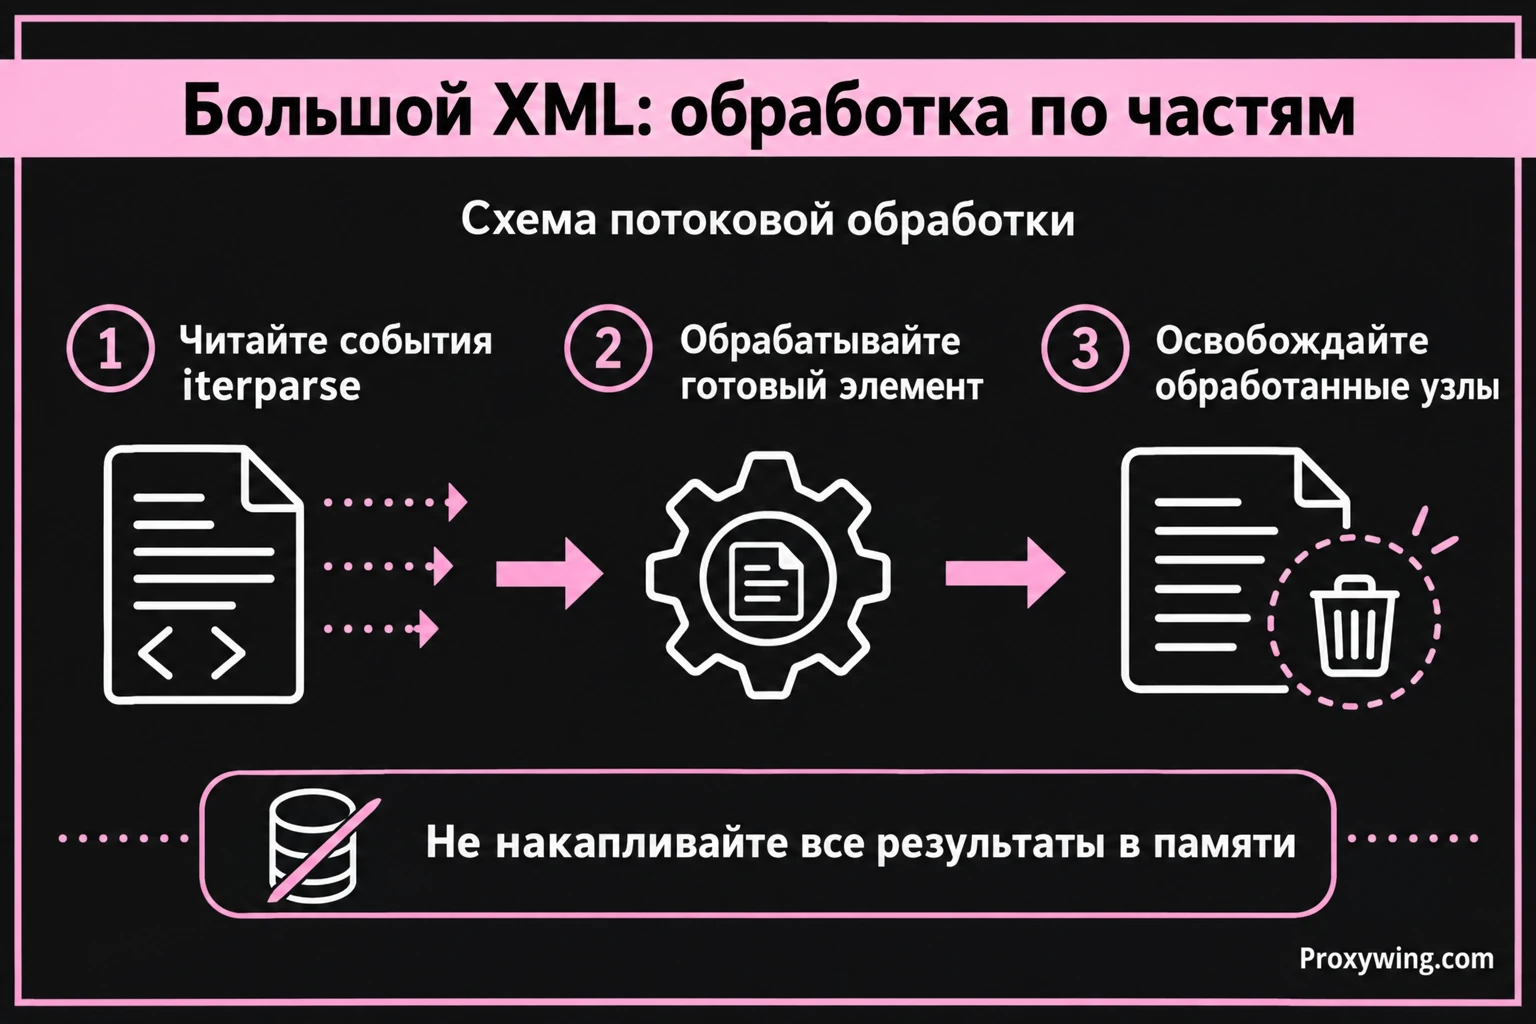
iterparse читает документ постепенно, но строит элементы дерева. Для ограничения памяти обработанные узлы нужно освобождать. Пример рассчитан на плоский catalog, где book находится непосредственно внутри корня:
import xml.etree.ElementTree as ET

with open("catalog.xml", "rb") as source:
    events = ET.iterparse(source, events=("start", "end"))
    _, root = next(events)
    for event, element in events:
        if event == "end" and element.tag == "book":
            print(element.get("id"), element.findtext("title"))
            root.remove(element)
            element.clear()
Данные читаются на событии end, когда содержимое book уже доступно. Удаление из родителя убирает сохранённую ссылку на узел. Для вложенных записей и namespace адаптируйте условие и определение родителя.
Пиковая память зависит в том числе от размера одной записи. Если нужны только отдельные значения и дерево не требуется, рассмотрите SAX. Не накапливайте все обработанные записи в списке.
Пример читает catalog.xml и сохраняет результат в отдельный файл:
import xml.etree.ElementTree as ET

tree = ET.parse("catalog.xml")
book = tree.getroot().find("book[@id='b1']")
if book is not None:
    book.set("category", "programming")
    title = book.find("title")
    if title is not None:
        title.text = "Python Basics"
tree.write("changed.xml", encoding="utf-8", xml_declaration=True)
Изменение объекта в памяти само по себе не обновляет исходный файл. Вызов write выполняет запись.
Этот самостоятельный пример добавляет книгу к исходному catalog.xml:
import xml.etree.ElementTree as ET

tree = ET.parse("catalog.xml")
root = tree.getroot()
book = ET.SubElement(root, "book", id="b3")
ET.SubElement(book, "title").text = "Data Processing"
ET.SubElement(book, "price").text = "450"
tree.write("added.xml", encoding="utf-8", xml_declaration=True)
Если документ использует namespace, новые теги тоже должны принадлежать нужному пространству имён. Значения атрибутов и текста передаются строками.
Удалять узел нужно из его родителя. Здесь родитель book известен: это catalog.
import xml.etree.ElementTree as ET

tree = ET.parse("catalog.xml")
root = tree.getroot()
for book in root.findall("book"):
    if book.get("id") == "b2":
        root.remove(book)
tree.write("removed.xml", encoding="utf-8", xml_declaration=True)
findall создаёт список выбранных элементов перед удалением. Это помогает избежать пропуска соседних узлов при изменении дерева во время обхода.
Для UTF-8 и XML-декларации:
import xml.etree.ElementTree as ET

tree = ET.parse("catalog.xml")
tree.write("saved.xml", encoding="utf-8", xml_declaration=True)
ElementTree.indent добавляет отступы для чтения человеком и доступен начиная с Python 3.9. Форматирование меняет пробельный текст. Для документов со смешанным содержимым, цифровой подписью или требованием точного побайтового совпадения такое изменение может быть неприемлемо.
Обычное чтение и повторное сохранение XML не гарантирует сохранение исходного оформления.
Передавайте парсеру файл или исходные байты, чтобы он мог учесть XML-декларацию и BOM. Если байты уже декодированы неверно, последующий парсинг не восстановит исходные символы.
При записи указывайте encoding=”utf-8″. Для строкового результата через tostring можно выбрать encoding=”unicode”. Не смешивайте строковый результат с файлом, открытым в бинарном режиме.
Для учебного каталога можно описать одну запись через dataclass:
from dataclasses import dataclass
from decimal import Decimal
import xml.etree.ElementTree as ET

@dataclass
class Book:
    id: str
    title: str
    price: Decimal

root = ET.parse("catalog.xml").getroot()
books = []
for element in root.findall("book"):
    book_id = element.get("id")
    title = element.findtext("title")
    price = element.findtext("price")
    if book_id is None or title is None or price is None:
        raise ValueError("У книги отсутствует обязательное поле")
    books.append(Book(book_id, title, Decimal(price)))

print(books[0].title)
Для цены используется Decimal. Некорректное числовое значение нужно обрабатывать как ошибку данных. Не подставляйте молча ноль вместо отсутствующей цены.
При повреждённом XML ElementTree сообщает ParseError. Пример обработки:
import xml.etree.ElementTree as ET

try:
    ET.fromstring("<catalog><book></catalog>")
except ET.ParseError as error:
    print("XML не разобран:", error)
    print("Строка и столбец:", error.position)
Проверьте закрывающие теги, корневой элемент, кодировку и исходный ответ. Если вместо XML получена HTML-страница, исправляйте этап загрузки.
Различия между ошибками кода, XML и JSON разобраны в инструкции по ошибкам парсинга в Python. Для проверки обязательных полей нужна отдельная логика или схема. XSD проверяет структуру и типы по правилам схемы, но не все условия вашего приложения.
Для недоверенного файла используйте защитный парсер и ограничения размера. Пример с defusedxml:
from pathlib import Path
from defusedxml.ElementTree import fromstring

limit = 5 * 1024 * 1024
with Path("catalog.xml").open("rb") as source:
    payload = source.read(limit + 1)
if len(payload) > limit:
    raise ValueError("XML превышает лимит 5 МиБ")
root = fromstring(payload, forbid_dtd=True)
print(root.tag)
Лимит 5 МиБ выбран для этого учебного примера. Настройте его под допустимый объём задачи. Запрет DTD и сущностей не заменяет ограничения памяти, времени и размера.
При сетевой загрузке дополнительно ограничьте время ожидания и количество прочитанных байтов, проверьте HTTP-статус и фактическое содержимое. Заголовок Content-Type помогает диагностике, но сам по себе не доказывает корректность XML.
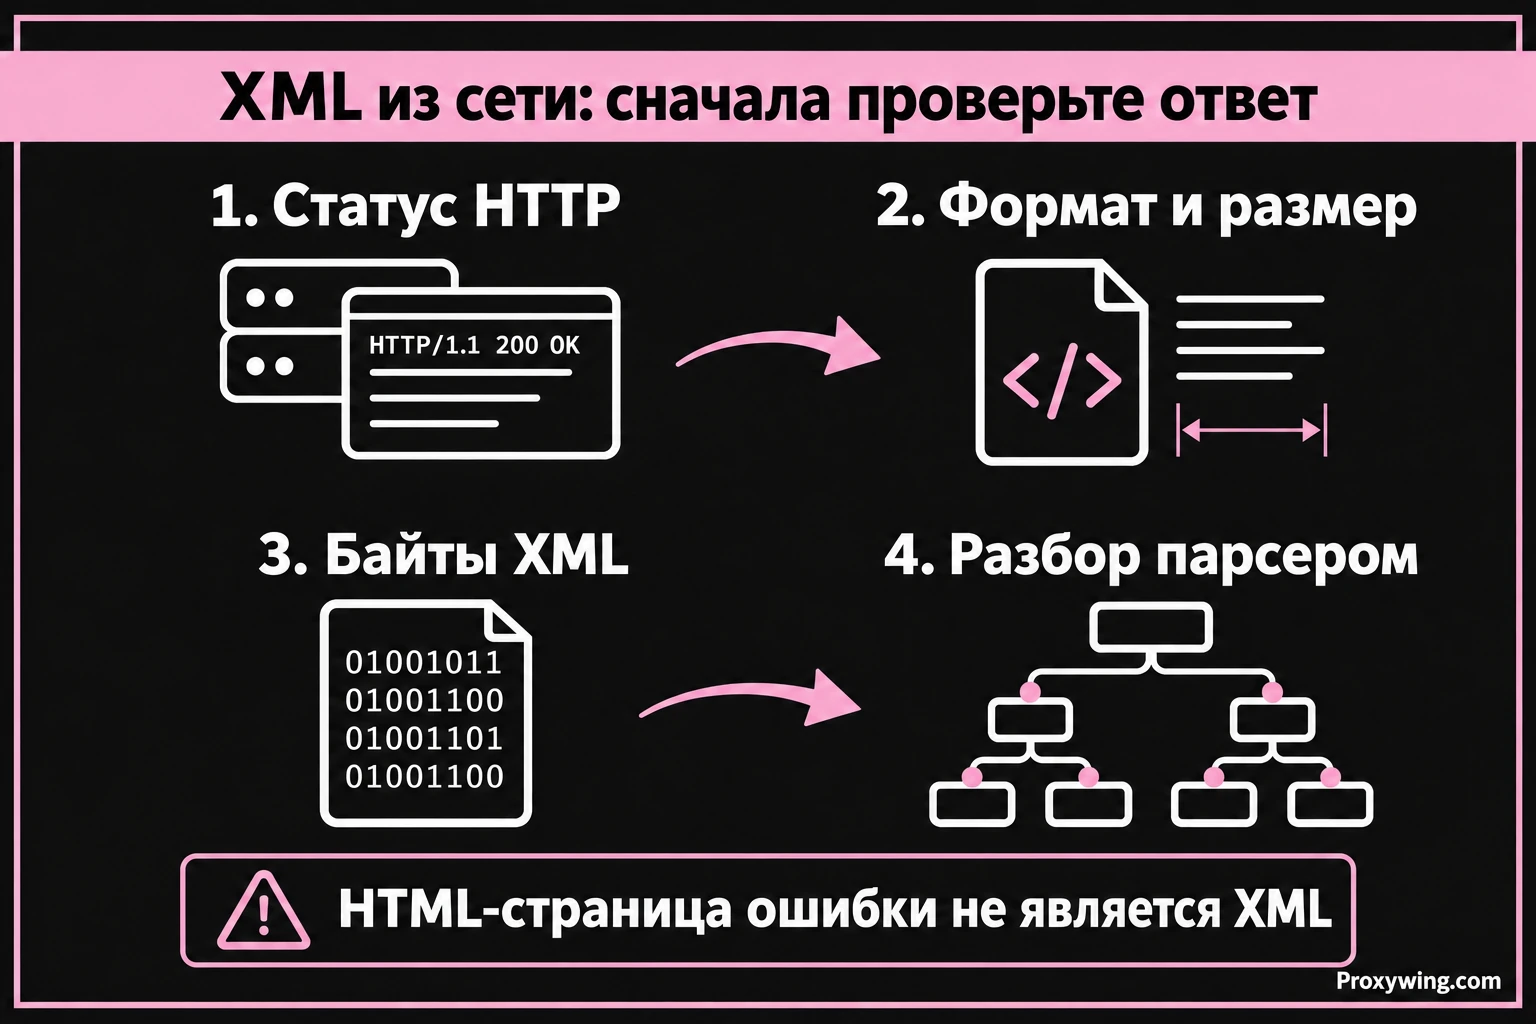
Проверьте небольшой корректный документ, отсутствие обязательного поля, повреждённый XML и файл больше допустимого размера. Для больших выгрузок измерьте память на реальном объёме.
Локальное чтение XML не требует прокси. Если XML загружается с сайта и нужен заданный внешний IP или регион, выберите прокси для парсинга в ProxyWing. Настройка сетевого этапа описана в руководстве по прокси для веб-скрапинга.
Для резидентских прокси действует промокод WINGRESI10: скидка 10% на резидентские прокси ProxyWing.
Статью написал:
Фулстек AI-инженер
Александр привносит в инженерную команду Proxywing глубокую фулстек-экспертизу — от архитектуры бэкенда и оптимизации производительности до AI-ориентированных процессов разработки. Его практический опыт охватывает Node.js, React, облачную инфраструктуру и RAG-пайплайны, что позволяет одинаково уверенно работать как с внутренней логикой прокси-платформы, так и с пользовательской частью продукта. В Proxywing Александр сосредоточен на проектировании отказоустойчивых систем, устранении узких мест производительности и внедрении современных AI-инструментов в процесс разработки. Вне кода он увлечён исследованием передовых подходов в AI-инженерии и созданием сайд-проектов, расширяющих технические горизонты.
Все статьи автора (58)